Entdecken Sie Whisper-Transkription, die für echte Stimmen entwickelte Spracherkennung
Ein klarer Blick auf Whisper-Transkription, das offene neuronale Netz, das Sprache mit nahezu menschlicher Genauigkeit transkribiert und übersetzt – selbst bei Akzenten, Lärm und Fachjargon.
Dieser Leitfaden behandelt Whisper-Transkription in der erstmals 2022 veröffentlichten Version.
Brauchen Sie heute ein fertiges Tool für Audio und Transkripte?
Transkriptionswerkzeug öffnenBeispiele für Whisper-Transkription:
„Okay, die Lieferung kommt am Dienstag an, die Rechnung geht am Mittwoch raus, und falls jemand fragt, wird die Demo auf Freitag um Punkt neun verschoben.“
„Wir sind in der Nähe des Hafens aufgewachsen, und jeden Sommer nahm mein Großvater uns vor Sonnenaufgang mit auf sein kleines Fischerboot.“
„Entschuldigung, es ist hier laut. Können Sie mich hören? Ich sagte, die Notizen zur Whisper-Transkription sind jetzt im freigegebenen Ordner.“
[Französisch nach Englisch] „Ich möchte bitte zwei Karten für das Konzert am Samstagabend buchen.“
Whisper-Transkription ist ein Spracherkennungsmodell, das aus 680.000 Stunden beschrifteten Audios aus vielen Sprachen und Aufgaben gelernt hat, die aus dem gesamten offenen Web stammen. Diese Breite zahlt sich aus: Das Modell kommt mit Akzenten, Hintergrundgeräuschen und Fachvokabular weit besser zurecht als eng trainierte Systeme. Es transkribiert Dutzende Sprachen und kann sie ins Englische übertragen. Die Gewichte und der Inferenzcode sind offen veröffentlicht, sodass Teams echte Produkte auf Whisper-Transkription aufbauen und Forschende robuste Sprachverarbeitung weiter vorantreiben können.
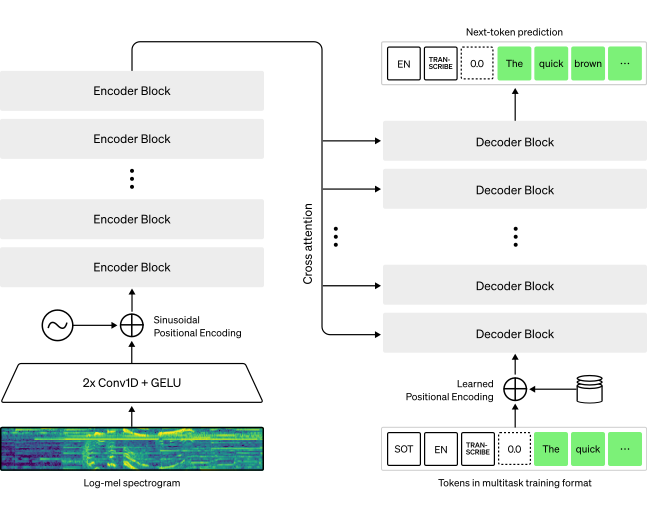
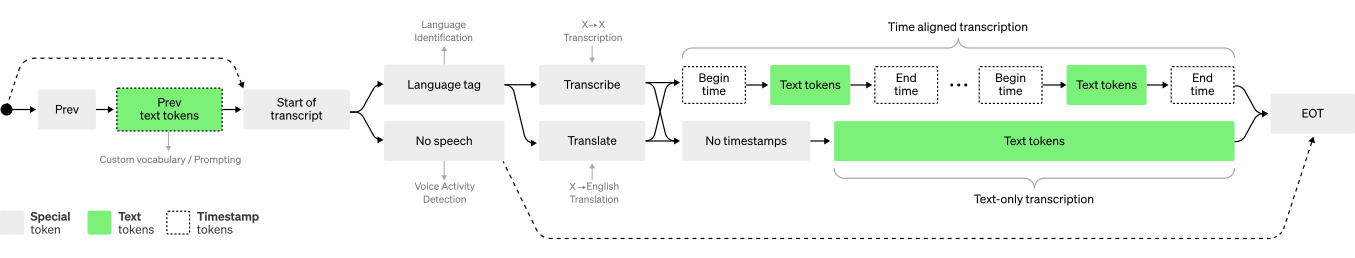
Unter der Haube ist Whisper-Transkription ein einfacher Encoder-Decoder-Transformer, der Ende zu Ende trainiert wurde. Eingehendes Audio wird in 30-Sekunden-Fenster geschnitten und in ein Log-Mel-Spektrogramm umgewandelt, bevor es den Encoder erreicht. Der Decoder sagt dann den passenden Text voraus, vermischt mit speziellen Tokens, die einem gemeinsamen Modell sagen, welche Aufgabe zu erledigen ist: die Sprache erkennen, jeden Satz mit Zeitstempeln versehen, in vielen Sprachen transkribieren oder Sprache ins Englische übersetzen.
Viele frühere Systeme stützen sich auf kleinere Datensätze, in denen Audio und Text eng aufeinander abgestimmt sind,1 2, 3 oder auf riesige unbeschriftete Audio-Korpora, die für das Vortraining verwendet werden.4, 5, 6 Weil Whisper-Transkription einen breiten, vielfältigen Datensatz gesehen hat und nie auf einen bestimmten Benchmark abgestimmt wurde, steht es auf LibriSpeech, dem klassischen Maßstab des Feldes, nicht an der Spitze der Spezialmodelle. Im Zero-Shot-Test über viele andere Datensätze hinweg erweist sich Whisper-Transkription jedoch als deutlich robuster und macht etwa halb so viele Fehler.
Etwa ein Drittel des Trainingsaudios von Whisper-Transkription ist nicht Englisch. Für diese Clips wird das Modell entweder gebeten, die Ausgangssprache aufzuschreiben oder sie ins Englische zu übersetzen. Diese Mischung vermittelt erstaunlich gut Sprach-zu-Text-Übersetzung und schlägt den überwachten Stand der Technik bei CoVoST2 ins Englische ganz ohne aufgabenspezifisches Training.
Englische Transkription
Jede Sprache nach Englisch
Nicht-englische Transkription
Keine Sprache
Trainingspaare für Whisper-Transkription: Audio rein, Text raus
Wir erwarten, dass die Genauigkeit und Einfachheit der Whisper-Transkription Spracheingabe für viele weitere Apps erreichbar machen. Werfen Sie einen erneuten Blick auf die Quellen, das Modelldiagramm und die Datenbeispiele für das vollständige Bild, dann verwandeln Sie Ihre eigenen Aufnahmen in Text.
Quellen
- 1
Chan et al. SpeechStew: alle verfügbaren Sprachdatensätze zusammenführen, um ein einziges großes Netzwerk zu trainieren. arXiv 2104.02133, 2021.
- 2
Galvez et al. The People’s Speech: ein großes, vielfältiges englisches Korpus, das für die kommerzielle Nutzung freigegeben ist. arXiv 2111.09344, 2021.
- 3
Chen et al. GigaSpeech: ein Multi-Domain-Korpus mit 10,000 Stunden transkribiertem Audio. arXiv 2106.06909, 2021.
- 4
Baevski, Zhou, Mohamed und Auli. wav2vec 2.0: selbstüberwachtes Lernen von Sprachmerkmalen. arXiv 2006.11477, 2020.
- 5
Baevski, Hsu, Conneau und Auli. Spracherkennung ohne Labels. NeurIPS 34, 2021.
- 6
Zhang et al. BigSSL: Skalierung des halbüberwachten Lernens für die Spracherkennung. arXiv 2109.13226, 2021.