Découvrez transcription Whisper, la reconnaissance vocale conçue pour de vraies voix
Un regard clair sur transcription Whisper, le réseau neuronal ouvert qui transcrit et traduit la parole avec une précision proche de l'humain, même à travers les accents, le bruit et le jargon.
Ce guide présente transcription Whisper dans sa version initiale de 2022.
Besoin d'un outil prêt à l'emploi pour l'audio et les transcriptions dès aujourd'hui ?
Ouvrez le transcripteurExemples de transcription Whisper :
« D’accord, la livraison arrive mardi, la facture part mercredi, et si quelqu’un demande, la démo est déplacée à vendredi neuf heures précises. »
« Nous avons grandi près du port, et chaque été mon grand-père nous emmenait sur son petit bateau de pêche avant le lever du soleil. »
« Désolé, c’est bruyant ici. Vous m’entendez ? J’ai dit que les notes de transcription Whisper sont maintenant dans le dossier partagé. »
[Français vers anglais] “I would like to book two tickets for the Saturday night concert, please.”
Le modèle transcription Whisper est un système de reconnaissance vocale qui a appris à partir de 680,000 heures d’audio étiqueté couvrant de nombreuses langues et tâches, collectées sur le web ouvert. Cette diversité porte ses fruits : le modèle gère les accents, les bruits de fond et le vocabulaire technique bien mieux que les systèmes entraînés de façon étroite. Il transcrit des dizaines de langues et peut les restituer en anglais. Les poids et le code d’inférence sont publiés ouvertement, afin que les équipes puissent construire de vrais produits sur le modèle transcription Whisper et que les chercheurs puissent continuer à faire progresser un traitement robuste de la parole.
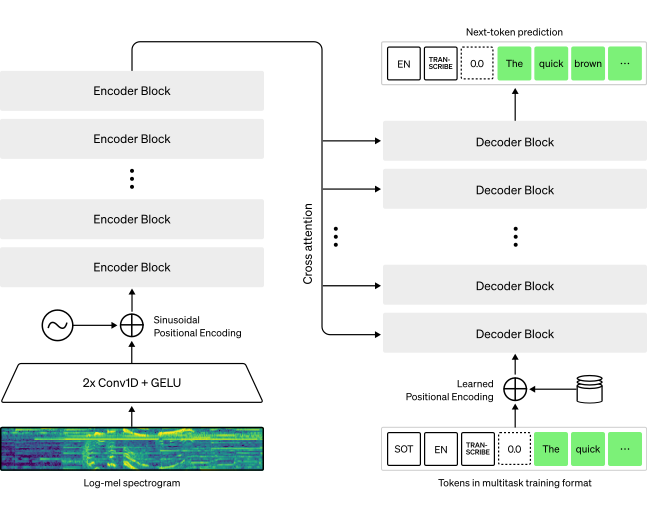
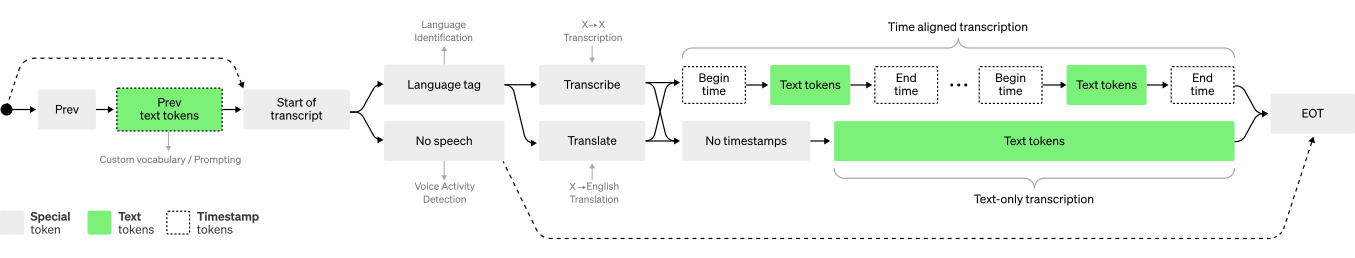
Sous le capot, le modèle transcription Whisper est un simple Transformer encodeur-décodeur entraîné de bout en bout. L’audio entrant est découpé en fenêtres de 30 secondes et transformé en spectrogramme log-Mel avant d’atteindre l’encodeur. Le décodeur prédit ensuite le texte correspondant, mélangé à des jetons spéciaux qui indiquent à un modèle partagé quelle tâche effectuer : détecter la langue, horodater chaque phrase, transcrire dans de nombreuses langues ou traduire la parole en anglais.
De nombreux systèmes antérieurs s’appuient sur des jeux de données plus petits où l’audio et le texte sont étroitement appariés,1 2, 3 ou sur d’immenses corpus audio non étiquetés utilisés pour le préentraînement.4, 5, 6 Parce que le modèle transcription Whisper a vu un jeu de données vaste et varié et n’a jamais été ajusté pour un seul benchmark, il ne dépasse pas les modèles spécialisés sur LibriSpeech, l’étalon classique du domaine. Testé en zéro-shot sur de nombreux autres jeux de données, toutefois, le modèle transcription Whisper se révèle bien plus robuste et commet environ deux fois moins d’erreurs.
Environ un tiers de l’audio d’entraînement du modèle transcription Whisper n’est pas en anglais. Pour ces clips, on demande au modèle soit de retranscrire la langue source, soit de la traduire en anglais. Ce mélange s’avère enseigner remarquablement bien la traduction parole-texte, dépassant l’état de l’art supervisé sur CoVoST2 vers l’anglais sans aucun entraînement spécifique à la tâche.
Transcription en anglais
Toute langue vers l’anglais
Transcription non anglaise
Aucune parole
Paires d’entraînement de transcription Whisper : audio en entrée, texte en sortie
Nous pensons que la précision et la simplicité de la transcription Whisper mettront la saisie vocale à la portée de beaucoup plus d’applications. Revenez sur les sources, le diagramme du modèle et les échantillons de données pour avoir une vue d’ensemble, puis transformez vos propres enregistrements en texte.
Sources
- 1
Chan et al. SpeechStew : regrouper tous les ensembles de données vocales disponibles pour entraîner un grand réseau. arXiv 2104.02133, 2021.
- 2
Galvez et al. The People’s Speech : un corpus anglais vaste et varié autorisé pour une utilisation commerciale. arXiv 2111.09344, 2021.
- 3
Chen et al. GigaSpeech : un corpus multi-domaines contenant 10,000 heures d’audio transcrit. arXiv 2106.06909, 2021.
- 4
Baevski, Zhou, Mohamed et Auli. wav2vec 2.0 : apprentissage auto-supervisé des caractéristiques de la parole. arXiv 2006.11477, 2020.
- 5
Baevski, Hsu, Conneau et Auli. Reconnaissance vocale sans étiquettes. NeurIPS 34, 2021.
- 6
Zhang et al. BigSSL : mise à l'échelle de l'apprentissage semi-supervisé pour la reconnaissance vocale. arXiv 2109.13226, 2021.