Whisperai

Guide du modèle

Guide pratique d’OpenAI transcription Whisper

OpenAI transcription Whisper est un modèle de reconnaissance vocale conçu pour convertir des fichiers audio enregistrés ou en direct en texte. Ce guide distingue le modèle lui-même de l’expérience en ligne plus large, puis montre dans quels cas chaque approche est adaptée.

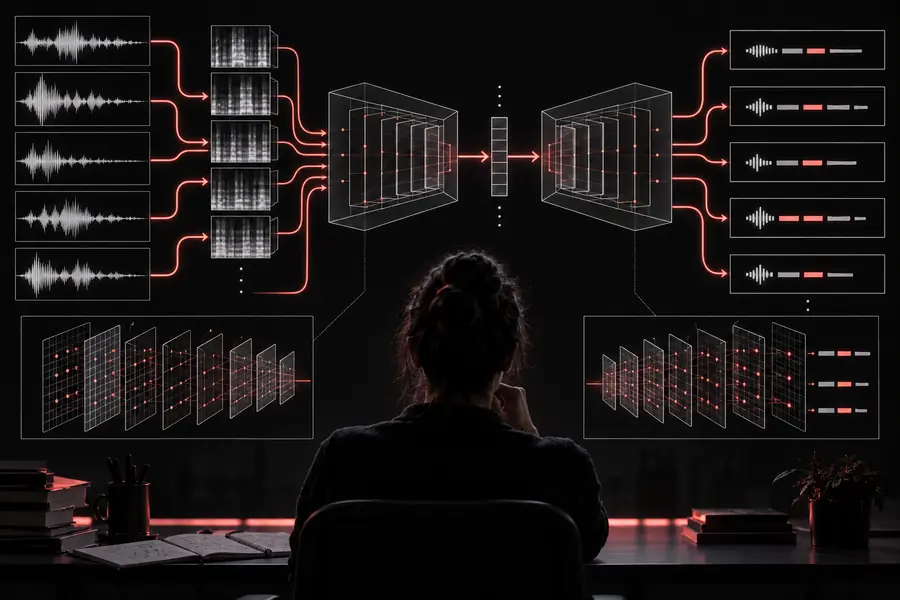
Flux de travail OpenAI transcription Whisper montrant la transformation de l’audio en texte

Les limites à connaître avant de choisir une approche

Le modèle est performant, mais il ne constitue pas à lui seul un flux de production complet. Ces limites sont importantes lorsque vous devez décider de l’exécuter directement ou d’utiliser une interface gérée.

Il ne garantit pas la transcription parfaite des noms

OpenAI transcription Whisper peut mal interpréter les noms peu courants, les acronymes, les marques et le vocabulaire spécialisé, en particulier lorsque l’enregistrement est bruyant ou que plusieurs personnes parlent en même temps.

Solution de contournement

Vérifiez les noms propres et ajoutez une étape de contrôle de la terminologie avant de publier la transcription.
Il ne remplace pas une édition prenant en compte les intervenants

Une transcription brute peut ne pas identifier correctement chaque intervenant ni préserver la structure d’une table ronde, d’une réunion ou d’un entretien sans traitement supplémentaire.

Solution de contournement

Utilisez des étiquettes d’intervenants, des horodatages et une étape de vérification humaine pour les enregistrements réunissant plusieurs personnes.

Ce n’est pas un produit de prise de notes finalisé

Le modèle produit du texte reconnu ; il ne crée pas automatiquement le résumé, le journal des décisions ou la base de connaissances consultable de votre choix.

Solution de contournement

Envoyez la transcription vers un flux de prise de notes ou de résumé après la transcription.

Il nécessite un environnement d’exécution adapté

L’exécution directe du modèle nécessite un environnement, une gestion des fichiers audio et une puissance de calcul suffisante pour la taille de modèle choisie. La configuration fait partie du travail.

Solution de contournement

Utilisez une interface web pour effectuer des tests rapides, ou optez pour une configuration locale maintenue lorsque le contrôle et la reproductibilité sont importants.

Comment commencer avec le modèle

Une première étape simple permet de garder la tâche mesurable : choisissez un court enregistrement, examinez le résultat, puis décidez si vous avez besoin d’un flux de travail plus complet.

  1. 1

    Choisissez un échantillon propre

    Commencez par un fichier court qui représente votre audio réel. Notez le bruit de fond, les accents, les locuteurs qui parlent en même temps et la langue que vous souhaitez faire reconnaître.

  2. 2

    Lancez la transcription

    Envoyez l’enregistrement via le moyen de votre choix et examinez le texte brut. Gardez l’audio d’origine à côté du résultat afin de pouvoir vérifier rapidement les phrases peu claires.

  3. 3

    Affinez le résultat

    Corrigez les noms, la ponctuation, les changements de locuteur et les termes propres à votre domaine. Si le résultat est utile, répétez le même processus sur un enregistrement plus long ou connectez-le à votre flux de travail de prise de notes.

Autres façons de travailler avec la transcription Whisper

Choisissez l’option qui correspond à votre prochaine tâche, qu’il s’agisse d’un environnement d’exécution plus rapide, d’une expérimentation dans un navigateur ou d’un flux de travail axé sur la transcription.

De l’audio brut à un texte exploitable

La différence entre la sortie d’un modèle et une transcription utile apparaît souvent lors de la phase de révision : le contexte, la ponctuation, les noms et les changements de locuteur nécessitent une attention particulière.

Audio enregistré préparé pour OpenAI transcription Whisper Entrée audio
Transcription révisée produite à partir d’un contenu audio parlé Transcription révisée
La sortie du modèle devient utile après révision et mise en forme.

Ce point d’entrée par rapport à l’approche générale

L’option du modèle vous offre davantage de contrôle sur l’étape de reconnaissance. Une option en ligne générale est généralement plus simple lorsque vous souhaitez tester une idée sans mettre en place le flux de travail environnant.

Option du modèle Whisper d’OpenAI
Option en ligne générale

Objectif principal

Option du modèle Whisper d’OpenAI

Exécuter ou évaluer un modèle de reconnaissance vocale

Option en ligne générale

Effectuez rapidement une tâche de transcription

Configuration

Route de modèle OpenAI de transcription Whisper

Peut nécessiter un environnement d’exécution, la gestion audio et une configuration

Route générale en ligne

Commence généralement dans un navigateur avec moins de décisions à prendre

Contrôle

Route de modèle OpenAI de transcription Whisper

Offre davantage de contrôle sur le choix du modèle, le traitement et la reproductibilité

Route générale en ligne

Des paramètres par défaut pratiques avec moins de contrôle de bas niveau

Meilleure première entrée

Route de modèle OpenAI de transcription Whisper

Un échantillon représentatif pour tester la précision et l’adéquation au flux de travail

Route générale en ligne

Un fichier que vous souhaitez convertir avec un minimum de préparation

Gestion des résultats

Route de modèle OpenAI de transcription Whisper

Vous décidez comment le texte, les horodatages et la révision évoluent

Route générale en ligne

Le service présente généralement un résultat prêt à lire

Mise à l’échelle du flux de travail

Route de modèle OpenAI de transcription Whisper

Peut prendre en charge un pipeline reproductible lorsqu’il est soigneusement maintenu

Route générale en ligne

Mieux adapté à un usage occasionnel ou léger

Responsabilité technique

Approche du modèle de transcription Whisper d’OpenAI

Vous êtes davantage responsable de l’environnement et du dépannage

Approche en ligne générale

Le service masque davantage l’infrastructure

Utilisateur idéal

Approche du modèle de transcription Whisper d’OpenAI

Développeurs, chercheurs et équipes ayant besoin de contrôle

Approche en ligne générale

Personnes qui souhaitent une expérience de transcription simple

Qui tire profit de chaque approche

Le bon choix dépend moins du nom du modèle que du niveau de contrôle, de vérification et d’infrastructure requis par votre travail.

Développeur

Vous avez besoin d’une étape de conversion de la parole en texte reproductible au sein d’une application ou d’un pipeline interne.

Une approche centrée sur le modèle vous permet de contrôler les entrées, le traitement et les résultats en aval.

faster-whisper

Chercheur

Vous comparez la qualité de reconnaissance selon les accents, les conditions d’enregistrement ou les langues.

Un processus contrôlé d’échantillonnage et de vérification facilite l’examen et la reproductibilité des résultats.

STT transcription Whisper

Éditeur de contenu

Vous avez une interview ou un podcast et avez besoin d’un texte lisible avant de le transformer en article.

Un flux de travail axé sur la transcription vous aide à passer de la reconnaissance brute à un texte corrigé.

transcription Whisper

Testeur curieux

Vous voulez voir ce que la reconnaissance vocale peut faire sans planifier une configuration technique complète.

Une expérience basée sur le Web est un moyen plus simple d’évaluer l’expérience avant d’aller plus loin.

Démo Web de transcription Whisper

Commencez par une transcription réellement exploitable

Essayez d’abord un court enregistrement, examinez le résultat et déterminez si vous avez besoin d’un transfert en ligne simple ou d’un flux de travail avec modèle plus contrôlé. Whisperai vous aide à passer à l’étape suivante sans confondre le modèle avec l’ensemble du produit.

Essayez la transcription Whisper maintenant
  • Testez un échantillon audio représentatif
  • Vérifiez les noms et les changements d’intervenant
  • Passez du texte brut à des notes utiles

FAQ sur OpenAI transcription Whisper

Ces réponses couvrent les questions pratiques que les utilisateurs posent généralement lorsqu’ils évaluent le modèle et sa place dans un flux de travail de transcription.

OpenAI transcription Whisper sert à reconnaître la langue parlée et à convertir l’audio en texte. Il peut prendre en charge les transcriptions, les sous-titres, les enregistrements indexables et la synthèse ultérieure, mais le flux de travail environnant détermine toujours le niveau de finition du résultat final.

Non. Le modèle constitue le composant de reconnaissance vocale, tandis qu’un outil en ligne ajoute la gestion des fichiers, des choix d’interface, la présentation des résultats et parfois des fonctionnalités de modification. Une solution en ligne est souvent plus simple ; un flux de travail utilisant directement le modèle offre davantage de contrôle.

Commencez par un court enregistrement qui reflète votre cas d’utilisation réel, puis faites-le passer par une solution adaptée et comparez le texte avec l’audio. Vérifiez les noms, la ponctuation, les accents et les changements d’intervenant avant de décider d’élargir le flux de travail.

Il peut souvent produire un texte utile à partir d’enregistrements variés, y compris des fichiers audio avec des accents ou du bruit de fond, mais la précision dépend de la clarté, des chevauchements, du vocabulaire et de la qualité de l’enregistrement. Considérez les passages difficiles comme des points à vérifier plutôt que de supposer que chaque mot est correct.

Il peut fournir une première transcription solide pour les réunions et les entretiens, en particulier lorsque l’audio est clair. Vous devez tout de même vérifier l’attribution des propos, les noms, les décisions et les passages peu clairs avant de partager le résultat ou de le transformer en notes.

Commencer la transcription