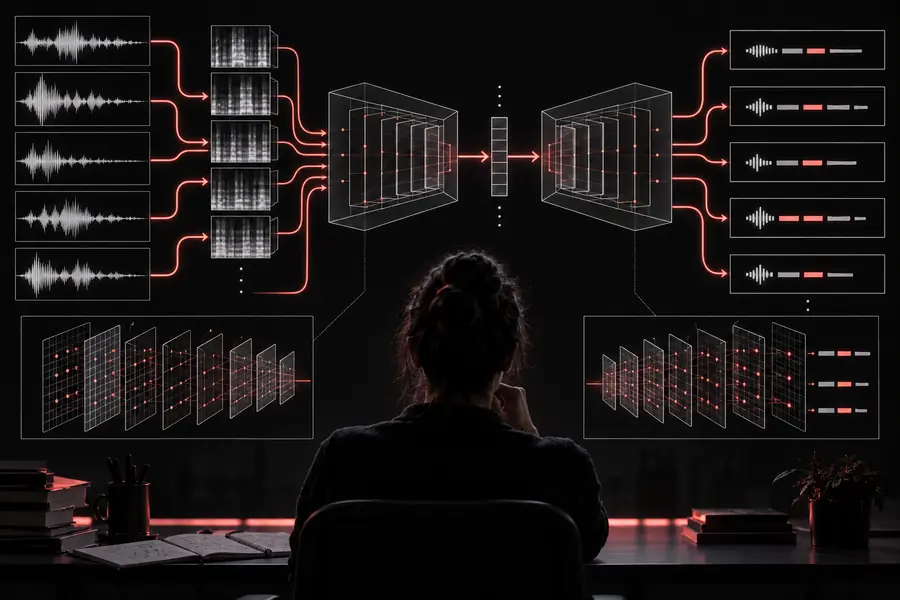
O OpenAI Whisper é um modelo de reconhecimento de fala desenvolvido para transformar áudio gravado ou ao vivo em texto. Este guia separa o modelo em si da experiência online mais ampla e mostra onde cada opção se encaixa.
O modelo é capaz, mas não é, por si só, um fluxo de trabalho completo para produção. Esses limites são importantes quando você decide entre executá-lo diretamente ou usar uma interface gerenciada.
Ele não garante nomes perfeitos
O OpenAI Whisper pode interpretar incorretamente nomes incomuns, siglas, marcas e vocabulário especializado, especialmente quando a gravação tem ruído ou há sobreposição de vozes.
Alternativa
Revise nomes próprios e faça uma verificação de terminologia antes de publicar a transcrição.
Ele não substitui a edição com identificação de locutores
Uma transcrição bruta pode não identificar com segurança todos os locutores nem preservar a estrutura de um painel, reunião ou entrevista sem processamento adicional.
Alternativa
Use rótulos de locutores, marcas de tempo e uma etapa de revisão humana para gravações com várias pessoas.
Ele não é um produto de anotações pronto
O modelo produz texto reconhecido; ele não cria automaticamente o resumo, o registro de decisões ou a base de conhecimento pesquisável de sua preferência.
Alternativa
Envie a transcrição para um fluxo de trabalho de anotações ou resumo após a transcrição.
Ele precisa de um ambiente de execução prático
Executar o modelo diretamente exige um ambiente, tratamento de áudio e capacidade computacional suficiente para o tamanho de modelo escolhido. A configuração faz parte do trabalho.
Alternativa
Use uma opção web para testes rápidos ou uma configuração local mantida quando o controle e a repetibilidade forem importantes.
Como começar a usar o modelo
Uma primeira etapa simples mantém a tarefa mensurável: escolha uma gravação curta, examine o resultado e então decida se precisa de um fluxo de trabalho mais completo.
1
Escolha uma amostra limpa
Comece com um arquivo curto que represente seu áudio real. Observe o ruído de fundo, os sotaques, os falantes sobrepostos e o idioma que você espera reconhecer.
2
Execute a transcrição
Envie a gravação pela rota escolhida e revise o texto bruto. Mantenha o áudio original ao lado do resultado para que as frases pouco claras possam ser verificadas rapidamente.
3
Aperfeiçoe o resultado
Corrija nomes, pontuação, mudanças de falante e termos específicos do domínio. Se o resultado for útil, repita o mesmo processo em uma gravação mais longa ou conecte-o ao seu fluxo de trabalho de anotações.
Formas relacionadas de trabalhar com a transcrição do Whisper
Escolha a rota que corresponde à sua próxima tarefa, desde um ambiente de execução mais rápido até um experimento baseado no navegador ou um fluxo de trabalho focado em transcrição.
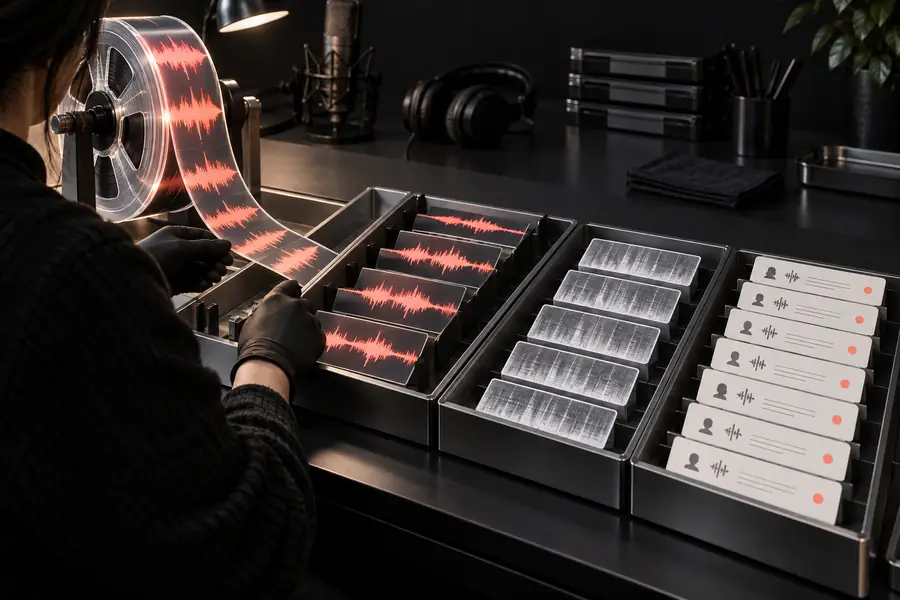
A diferença entre a saída de um modelo e uma transcrição útil geralmente fica evidente na etapa de revisão: contexto, pontuação, nomes e mudanças de falante precisam de atenção.
Entrada de áudio
Transcrição revisada
A saída do modelo se torna útil após a revisão e a formatação.
Esta rota em comparação com a geral
A rota do modelo oferece mais controle sobre a etapa de reconhecimento. Uma rota online geral costuma ser mais fácil quando você quer testar uma ideia sem montar o fluxo de trabalho ao redor.
Rota do modelo de transcrição do Whisper da OpenAI
Rota online geral
Objetivo principal
Rota do modelo de transcrição do Whisper da OpenAI
Execute ou avalie um modelo de reconhecimento de fala
Rota online geral
Conclua uma tarefa rápida de transcrição
Configuração
Rota do modelo de transcrição do Whisper da OpenAI
Pode exigir um ambiente de execução, manipulação de áudio e configuração
Rota online geral
Geralmente começa no navegador, com menos decisões
Controle
Rota do modelo de transcrição do Whisper da OpenAI
Mais controle sobre a escolha do modelo, o processamento e a repetibilidade
Rota online geral
Padrões convenientes com menos controle de baixo nível
Melhor primeira entrada
Rota do modelo de transcrição do Whisper da OpenAI
Uma amostra representativa para testar a precisão e a adequação do fluxo de trabalho
Rota online geral
Um arquivo que você deseja converter com o mínimo de preparação
Tratamento da saída
Rota do modelo de transcrição do Whisper da OpenAI
Você decide como o texto, as marcas de tempo e a revisão avançam
Rota online geral
O serviço normalmente apresenta um resultado pronto para leitura
Escalonando o fluxo de trabalho
Rota do modelo de transcrição do Whisper da OpenAI
Pode oferecer suporte a um pipeline repetível quando mantido cuidadosamente
Rota online geral
Mais adequado para uso ocasional ou leve
Responsabilidade técnica
Rota do modelo Whisper da OpenAI
Você fica responsável por mais aspectos do ambiente e da solução de problemas
Rota online geral
O serviço oculta uma parte maior da infraestrutura
Usuário ideal
Rota do modelo Whisper da OpenAI
Desenvolvedores, pesquisadores e equipes que precisam de controle
Rota online geral
Pessoas que desejam uma experiência de transcrição simples
Quem se beneficia de cada rota
A escolha certa depende menos do nome do modelo e mais do nível de controle, revisão e infraestrutura que o seu trabalho exige.
Desenvolvedor
Você precisa de uma etapa repetível de conversão de fala em texto dentro de um aplicativo ou pipeline interno.
Uma rota centrada no modelo oferece espaço para controlar as entradas, o processamento e a saída posterior.
Comece com uma transcrição que você realmente possa usar
Experimente primeiro uma gravação curta, examine o resultado e decida se precisa de uma solução online simples ou de um fluxo de trabalho de modelo mais controlado. A Whisperai ajuda você a dar o próximo passo sem confundir o modelo com o produto inteiro.
Perguntas frequentes sobre a transcrição do Whisper da OpenAI
Estas respostas abrangem as perguntas práticas que as pessoas geralmente fazem ao avaliar o modelo e seu papel em um fluxo de trabalho de transcrição.
A transcrição do Whisper da OpenAI é usada para reconhecer a fala e converter áudio em texto. Ela pode gerar transcrições, legendas, gravações pesquisáveis e resumos posteriores, mas o fluxo de trabalho ao redor ainda determina o nível de qualidade do resultado final.
Não. O modelo é o componente de reconhecimento de fala, enquanto uma ferramenta online adiciona gerenciamento de arquivos, decisões de interface, apresentação do resultado e, às vezes, recursos de edição. Uma solução online costuma ser mais simples; um fluxo de trabalho direto com o modelo oferece mais controle.
Comece com uma gravação curta que reflita seu caso de uso real, passe-a por uma solução adequada e compare o texto com o áudio. Verifique nomes, pontuação, sotaques e mudanças de locutor antes de decidir se deve ampliar o fluxo de trabalho.
Ela geralmente consegue produzir textos úteis a partir de gravações variadas, incluindo áudios com sotaques ou ruído de fundo, mas a precisão depende da clareza, da sobreposição de vozes, do vocabulário e da qualidade da gravação. Trate os trechos difíceis como pontos de revisão, em vez de presumir que todas as palavras estão corretas.
Ela pode fornecer uma primeira transcrição de alta qualidade para reuniões e entrevistas, especialmente quando o áudio é claro. Ainda assim, você deve revisar a identificação dos locutores, os nomes, as decisões e os trechos pouco claros antes de compartilhar o resultado ou transformá-lo em anotações.