Una guía práctica de OpenAI transcripción de Whisper
OpenAI transcripción de Whisper es un modelo de reconocimiento de voz diseñado para convertir audio grabado o en directo en texto. Esta guía distingue el modelo en sí de la experiencia online más amplia y, después, muestra dónde encaja cada opción.
Límites que debes conocer antes de elegir una opción
El modelo es capaz, pero por sí solo no constituye un flujo de trabajo de producción completo. Estos límites son importantes al decidir si ejecutarlo directamente o utilizar una interfaz gestionada.
No garantiza nombres perfectos
OpenAI transcripción de Whisper puede interpretar mal nombres poco comunes, acrónimos, marcas y vocabulario especializado, especialmente cuando la grabación tiene ruido o varios hablantes hablan a la vez.
Solución alternativa
Revisa los nombres propios y añade una fase de revisión de terminología antes de publicar la transcripción.
No sustituye la edición con identificación de hablantes
Es posible que una transcripción en bruto no identifique de forma fiable a cada hablante ni conserve la estructura de un panel, una reunión o una entrevista sin procesamiento adicional.
Solución alternativa
Utiliza etiquetas de hablantes, marcas de tiempo y una etapa de revisión humana para las grabaciones con varias personas.
No es un producto de notas terminado
El modelo produce texto reconocido; no crea automáticamente el resumen que prefieras, un registro de decisiones ni una base de conocimiento consultable.
Solución alternativa
Envía la transcripción a un flujo de trabajo de notas o resumen después de la transcripción.
Necesita un entorno de ejecución práctico
Ejecutar el modelo directamente requiere un entorno, gestión del audio y suficiente capacidad de cómputo para el tamaño de modelo elegido. La configuración forma parte del trabajo.
Solución alternativa
Utiliza una opción web para realizar pruebas rápidas o una configuración local mantenida cuando el control y la reproducibilidad sean importantes.
Cómo empezar con el modelo
Un primer paso sencillo mantiene la tarea medible: elige una grabación corta, revisa el resultado y decide si necesitas un flujo de trabajo más completo.
1
Elige una muestra limpia
Empieza con un archivo corto que represente tu audio real. Ten en cuenta el ruido de fondo, los acentos, los hablantes que se superponen y el idioma que esperas reconocer.
2
Ejecuta la transcripción
Envía la grabación mediante la opción que hayas elegido y revisa el texto sin procesar. Mantén el audio original junto al resultado para poder comprobar rápidamente las frases que no estén claras.
3
Perfecciona el resultado
Corrige los nombres, la puntuación, los turnos de los hablantes y los términos del sector. Si el resultado es útil, repite el mismo proceso con una grabación más larga o conéctalo a tu flujo de trabajo de notas.
Formas relacionadas de trabajar con la transcripción de Whisper
Elige la opción que corresponda a tu próxima tarea, desde un entorno de ejecución más rápido hasta un experimento basado en el navegador o un flujo de trabajo centrado en la transcripción.
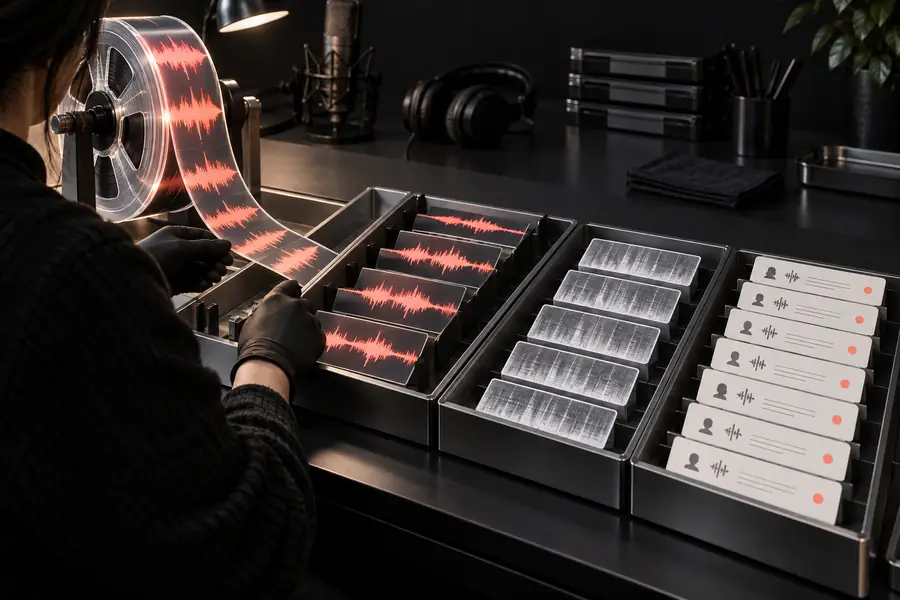
La diferencia entre el resultado de un modelo y una transcripción útil suele hacerse visible durante la etapa de revisión: es necesario prestar atención al contexto, la puntuación, los nombres y los cambios de hablante.
Entrada de audio
Transcripción revisada
El resultado del modelo se vuelve útil después de revisarlo y darle formato.
Esta opción frente a la general
La opción del modelo te proporciona más control sobre el paso de reconocimiento. Una opción general en línea suele ser más fácil cuando quieres probar una idea sin tener que crear el flujo de trabajo adicional.
Opción del modelo de transcripción de Whisper de OpenAI
Opción general en línea
Propósito principal
Opción del modelo de transcripción de Whisper de OpenAI
Ejecutar o evaluar un modelo de reconocimiento de voz
Opción general en línea
Completa una tarea rápida de transcripción
Configuración
Ruta del modelo de transcripción de Whisper de OpenAI
Puede requerir un entorno de ejecución, gestión de audio y configuración
Ruta general en línea
Normalmente comienza en un navegador con menos decisiones
Control
Ruta del modelo de transcripción de Whisper de OpenAI
Más control sobre la elección del modelo, el procesamiento y la reproducibilidad
Ruta general en línea
Valores predeterminados convenientes con menos control de bajo nivel
Mejor entrada inicial
Ruta del modelo de transcripción de Whisper de OpenAI
Una muestra representativa para probar la precisión y la adecuación del flujo de trabajo
Ruta general en línea
Un archivo que quieres convertir con una preparación mínima
Gestión de la salida
Ruta del modelo de transcripción de Whisper de OpenAI
Tú decides cómo avanzan el texto, las marcas de tiempo y la revisión
Ruta general en línea
El servicio normalmente presenta un resultado listo para leer
Escalar el flujo de trabajo
Ruta del modelo de transcripción de Whisper de OpenAI
Puede admitir un flujo de trabajo repetible cuando se mantiene cuidadosamente
Ruta general en línea
Más adecuada para un uso ocasional o ligero
Responsabilidad técnica
Ruta del modelo de transcripción de Whisper de OpenAI
Tienes más responsabilidad sobre el entorno y la resolución de problemas
Ruta general en línea
El servicio oculta una mayor parte de la infraestructura
Usuario ideal
Ruta del modelo de transcripción de Whisper de OpenAI
Creadores, investigadores y equipos que necesitan control
Ruta general en línea
Personas que quieren una experiencia de transcripción sencilla
Quién se beneficia de cada ruta
La elección adecuada depende menos del nombre del modelo que del nivel de control, revisión e infraestructura que requiera tu trabajo.
Desarrollador
Necesitas un paso de conversión de voz a texto repetible dentro de una aplicación o canalización interna.
Una ruta centrada en el modelo te permite controlar las entradas, el procesamiento y el resultado posterior.
Empieza con una transcripción que realmente puedas usar
Prueba primero con una grabación breve, revisa el resultado y decide si necesitas una transferencia sencilla en línea o un flujo de trabajo del modelo más controlado. Whisperai te ayuda a dar el siguiente paso sin confundir el modelo con el producto completo.
Preguntas frecuentes sobre OpenAI transcripción de Whisper
Estas respuestas cubren las preguntas prácticas que la gente suele hacer al evaluar el modelo y su lugar en un flujo de trabajo de transcripción.
OpenAI transcripción de Whisper se utiliza para reconocer el lenguaje hablado y convertir el audio en texto. Puede servir para crear transcripciones, subtítulos y grabaciones con capacidad de búsqueda, así como para resumir posteriormente, pero el flujo de trabajo que lo rodea sigue determinando el nivel de acabado del resultado final.
No. El modelo es el componente de reconocimiento de voz, mientras que una herramienta en línea añade gestión de archivos, decisiones sobre la interfaz, presentación del resultado y, en ocasiones, funciones de edición. La opción en línea suele ser más sencilla; un flujo de trabajo directo con el modelo ofrece más control.
Empieza con una grabación breve que refleje tu caso de uso real, pásala por una opción adecuada y compara el texto con el audio. Revisa los nombres, la puntuación, los acentos y los cambios de hablante antes de decidir si amplías el flujo de trabajo.
A menudo puede producir texto útil a partir de grabaciones variadas, incluido audio con acentos o ruido de fondo, pero la precisión depende de la claridad, la superposición de voces, el vocabulario y la calidad de la grabación. Trata las secciones difíciles como puntos de revisión en lugar de asumir que todas las palabras son correctas.
Puede proporcionar una primera transcripción sólida de reuniones y entrevistas, especialmente cuando el audio es claro. Aun así, debes revisar la atribución de los hablantes, los nombres, las decisiones y los pasajes poco claros antes de compartir el resultado o convertirlo en notas.