名前を完璧に認識できるとは限らない
OpenAI Whisper 音声認識は、特に録音環境が悪かったり、話者の発話が重なったりする場合、珍しい名前、頭字語、ブランド名、専門用語を聞き間違えることがあります。
回避策
固有名詞を確認し、文字起こしを公開する前に用語のチェック工程を追加します。
モデルガイド
OpenAI Whisper 音声認識は、録音またはライブ音声をテキストに変換するために構築された音声認識モデルです。このガイドでは、モデル自体と、より広範なオンライン体験を分けて説明し、それぞれの方法がどのような場面に適しているかを紹介します。
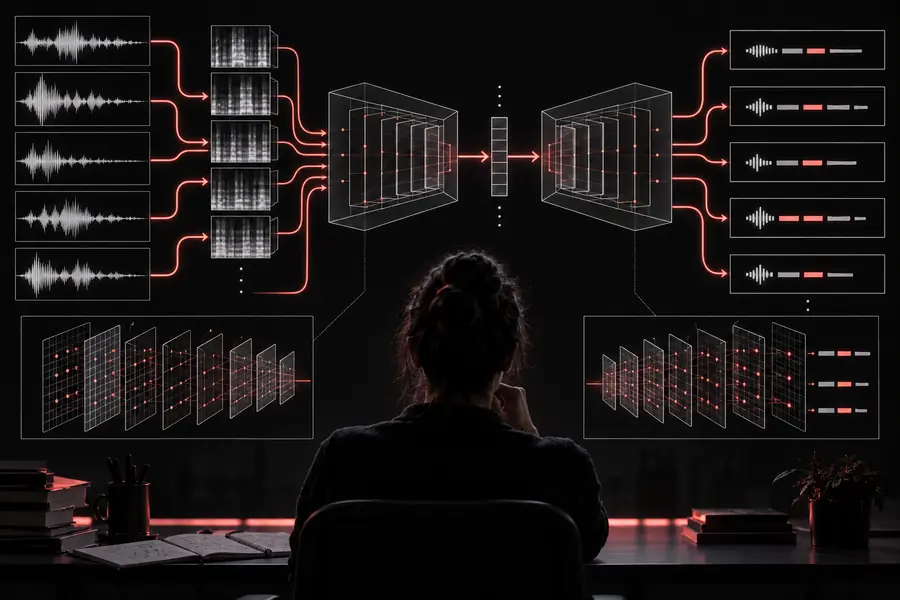
このモデルには十分な能力がありますが、それだけで完全な本番ワークフローになるわけではありません。直接実行するか、管理されたインターフェースを使うかを判断する際には、こうした制約が重要になります。
OpenAI Whisper 音声認識は、特に録音環境が悪かったり、話者の発話が重なったりする場合、珍しい名前、頭字語、ブランド名、専門用語を聞き間違えることがあります。
回避策
固有名詞を確認し、文字起こしを公開する前に用語のチェック工程を追加します。
生の文字起こしでは、追加の処理を行わない限り、すべての話者を確実に識別したり、パネルディスカッション、会議、インタビューの構成を維持したりできない場合があります。
回避策
複数人の録音には、話者ラベル、タイムスタンプ、人による確認工程を使用します。
このモデルが生成するのは認識されたテキストであり、好みの要約、意思決定ログ、検索可能なナレッジベースを自動的に作成するわけではありません。
回避策
文字起こし後に、ノート作成または要約のワークフローへ文字起こし結果を送ります。
モデルを直接実行するには、環境、音声処理、選択したモデルサイズに応じた十分な計算リソースが必要です。セットアップも作業の一部です。
回避策
簡単なテストにはウェブ経由の方法を使い、制御性と再現性が重要な場合は、保守されたローカル環境を使用します。
最初の試行は、測定可能な形にすると簡単です。短い録音を選び、出力を確認してから、より充実したワークフローが必要かどうかを判断します。
実際の音声を代表する短いファイルから始めます。背景ノイズ、アクセント、話者の重なり、認識したい言語を確認してください。
選択した方法で録音を送信し、生のテキストを確認します。不明瞭なフレーズをすぐに確認できるよう、元の音声を結果のそばに置いておきます。
名前、句読点、話者の切り替わり、専門用語を修正します。出力が役立つ場合は、同じ手順をより長い録音に繰り返すか、メモのワークフローに接続してください。
より高速なランタイム、ブラウザベースの実験、文字起こしに特化したワークフローなど、次のタスクに合った方法を選択してください。
モデルの出力と使える文字起こしの違いは、レビュー段階で明らかになることがよくあります。文脈、句読点、名前、話者の変更に注意を払う必要があります。
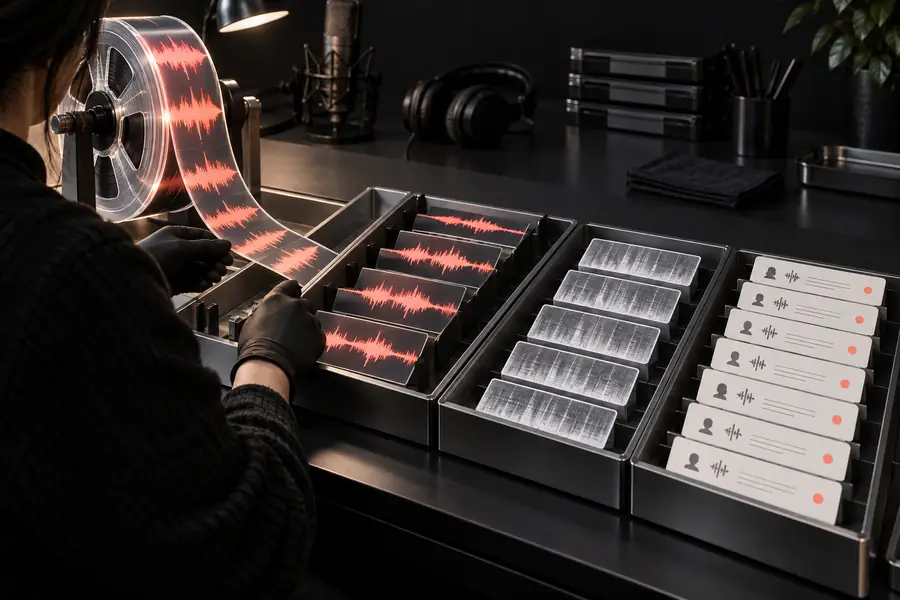 音声入力
レビュー済みの文字起こし
モデルのルートでは、認識のステップをより細かく制御できます。周辺のワークフローを組み立てずにアイデアを試したい場合は、一般的なオンラインルートのほうが通常は簡単です。
主な目的
OpenAI Whisper 音声認識モデルのルート
音声認識モデルを実行または評価する
一般的なオンラインルート
簡単な文字起こしタスクを完了する
セットアップ
OpenAI Whisper 音声認識モデルのルート
ランタイム、音声処理、設定が必要になる場合があります
一般的なオンラインルート
通常はブラウザで開始し、選択肢も少なくて済みます
操作性
OpenAI Whisper 音声認識モデルのルート
モデルの選択、処理、再現性をより細かく管理できます
一般的なオンラインルート
低レベルの制御は少ないものの、便利なデフォルト設定を利用できます
最初に入力するのに最適なもの
OpenAI Whisper 音声認識モデルのルート
精度とワークフローへの適合性をテストするための代表的なサンプル
一般的なオンラインルート
最小限の準備で変換したいファイル
出力の処理
OpenAI Whisper 音声認識モデルのルート
テキスト、タイムスタンプ、レビューをどのように進めるかを決められます
一般的なオンラインルート
通常、サービス上でそのまま読める結果が表示されます
ワークフローの拡張
OpenAI Whisper 音声認識モデルのルート
注意深く保守すれば、再現性のあるパイプラインをサポートできます
一般的なオンラインルート
たまに使う場合や軽量な用途により適しています
技術面での責任
OpenAI Whisper 音声認識モデルのルート
環境やトラブルシューティングのより多くの部分を自分で管理します
一般的なオンラインルート
サービスがインフラの大部分を隠してくれます
理想的なユーザー
OpenAI Whisper 音声認識モデルのルート
管理性を必要とする開発者、研究者、チーム
一般的なオンラインルート
シンプルな文字起こし体験を求める人
適切な選択は、モデルの名前よりも、作業にどの程度の管理性、確認、インフラが必要かによって決まります。
アプリケーションや社内パイプラインに、再現可能な音声からテキストへの変換工程が必要です。
モデル中心のルートなら、入力、処理、後続の出力を管理する余地が生まれます。
faster-Whisper 音声認識インタビューやポッドキャストの内容を記事にまとめる前に、読みやすいテキストが必要です。
文字起こしを優先するワークフローなら、生の認識結果から修正済みの原稿へスムーズに進められます。
Whisper 音声認識による文字起こし本格的な技術セットアップを計画せずに、音声認識で何ができるのかを確かめたい方。
ウェブベースの実験なら、より深く検討する前に、少ない手間で使い心地を評価できます。
Whisper 音声認識 ウェブデモまずは短い録音を試し、結果を確認してから、シンプルなオンライン処理で十分か、より管理しやすいモデルワークフローが必要かを判断しましょう。Whisperai は、モデルそのものとプロダクト全体を混同することなく、次のステップへ進めるよう支援します。
今すぐ Whisper 音声認識を試すここでは、モデルを評価する際や、文字起こしワークフローにおける位置づけを検討する際に、一般的によく寄せられる実用的な疑問に答えます。
OpenAI Whisper 音声認識は、話し言葉を認識して音声をテキストに変換するために使われます。文字起こし、字幕、検索可能な録音、後からの要約などに活用できますが、最終的な仕上がりをどれだけ整えられるかは、周辺のワークフローにも左右されます。
いいえ。モデルは音声認識を担うコンポーネントであり、オンラインツールにはファイル処理、インターフェースの設計、出力の表示、場合によっては編集機能も加わります。オンラインの方法はより簡単なことが多く、モデルを直接使うワークフローではより細かな制御が可能です。
まず、実際の用途を反映した短い録音を用意し、適切な方法で処理して、音声とテキストを比較しましょう。ワークフローを拡張するか判断する前に、名前、句読点、アクセント、話者の切り替わりを確認してください。
アクセントや背景ノイズを含むさまざまな録音から、役立つテキストを生成できることが多いですが、精度は音声の明瞭さ、音声の重なり、語彙、録音品質によって異なります。難しい箇所は、すべての単語が正しいと決めつけず、確認が必要なポイントとして扱いましょう。
特に音声が明瞭な場合、会議やインタビューの初稿となる文字起こしを高い品質で作成できます。それでも、結果を共有したりメモにまとめたりする前に、話者の特定、名前、決定事項、不明瞭な箇所を確認してください。