同意を作成することはできません
技術的に正確な文字起こしであっても、すべての話者が録音、処理、公開に同意したことの証明にはなりません。
回避策
録音前に同意を文書化し、その同意記録を元ファイルと一緒に保管してください。
実践的な音声ワークフロー
これらのOpenAI Whisper 音声認識の例では、チームが生の録音から検索・確認可能なテキストへ移行する方法を紹介します。ワークフローを確認し、現実的な出力例を見て、自分の音声データに合わせてプロセスを調整できます。
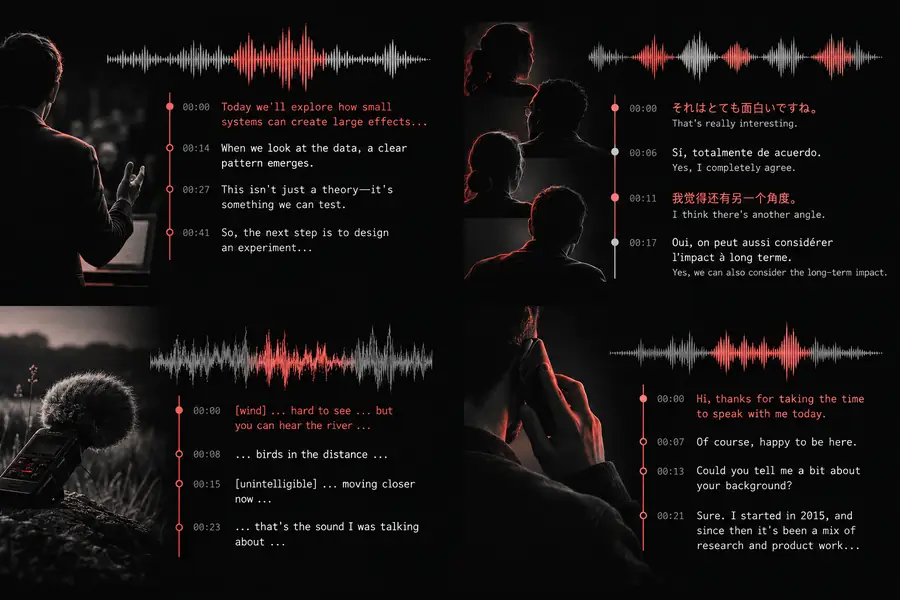
最も役立つWhisper 音声認識の例は、繰り返し利用できるものです。音声を収録し、文字起こしを行い、そのテキストを業務記録にする前に人による確認ステップを適用します。
インタビュー、会議、サポート通話、または現場メモを安定した形式で録音します。文字起こしを元の音声と照合できるよう、元ファイルを保管しておきます。
録音をWhisper 音声認識のワークフローに通し、用途に応じてタイムスタンプ、言語情報、話者ラベルを保持します。
名前、数字、専門用語、機密性の高い箇所を修正します。承認済みのテキストを、メモ、キャプション、調査アーカイブ、または社内ナレッジベースに書き出します。
役立つ結果は、単なる大量のテキストではありません。顧客インタビューの場合、レビュー担当者が重要な主張をすばやく確認できるよう、タイムスタンプと話者の発言区切りを保持した出力にすることがあります。
Whisper 音声認識は音声の処理に役立ちますが、録音が合法的に収集または共有されたかどうかを判断するものではありません。文字起こしは、管理されたワークフローにおける1つの工程として扱ってください。
技術的に正確な文字起こしであっても、すべての話者が録音、処理、公開に同意したことの証明にはなりません。
回避策
録音前に同意を文書化し、その同意記録を元ファイルと一緒に保管してください。
珍しい氏名、重なった発話、アクセント、会話の重なり、専門用語によって、もっともらしく見えても誤ったテキストが生成される場合があります。
回避策
氏名、数値、引用、医療用語、法律用語、顧客との約束については、人による確認を必須にしてください。
文字起こしによって、住所、アカウント情報、健康情報、または機密性の高い業務上の議論が、より検索しやすい形で露出する可能性があります。
回避策
出力を共有ストレージや後続システムに保存する前に、マスキングまたはアクセス制御を適用してください。
録音と文字起こしの両方を無期限に保管すると、情報漏えいのリスクが高まり、削除依頼への対応が難しくなる可能性があります。
回避策
形式ごとに保持期間を設定し、アクセスを制限し、承認された目的が終了したらファイルを削除してください。
主要形式
元の録音
自然な間や背景音を含む圧縮または非圧縮の音声
レビュー済みのWhisper 音声認識出力
タイムスタンプ、話者、または段落ごとに整理された検索可能なテキスト
人手
元の録音
引用や決定事項を見つけるには、誰かが録音を最初から最後まで聞く必要がある
レビュー済みのWhisper 音声認識出力
白紙の状態から始める代わりに、レビュアーが生成されたテキストを確認する
検索性
元の録音
ファイル名、フォルダー、手動で追加したメタデータに限定される
レビュー済みのWhisper 音声認識出力
単語、フレーズ、トピック、時間範囲をインデックス化できる
精度リスク
元の録音
意味は直接聞き取れるが、検索が遅く、一貫性に欠ける
レビュー済みのWhisper 音声認識出力
特に発話の重なり、専門用語、アクセント、氏名がある場合、テキストに誤りが含まれる可能性がある
最適な用途
元の録音
検証および再処理のための一次情報
レビュー済みのWhisper 音声認識出力
メモ、キャプション、調査コーディング、要約、承認済みの社内記録
ガバナンス
元の録音
ファイルを再生できる人によってアクセスが決まります
レビュー済みのWhisper 音声認識の出力
テキストには、独自の権限、編集・墨消し、保持、監査のルールが必要です
推奨される次のステップ
元の録音
元の録音を保持し、そのコンテキストを記録します
レビュー済みのWhisper 音声認識の出力
重要な箇所をレビューしてから、承認済みのバージョンのみを公開またはエクスポートします
まずは、繰り返し実行できるワークフローを1つ始めましょう。会話を文字起こしし、重要な箇所を確認して、承認済みの結果をメモや検索可能なテキストに変換します。同じパターンを、1件のインタビューから大規模な音声アーカイブまで拡張できます。
文字起こしワークフローを試す実際の音声ワークフローでWhisper 音声認識の例を使用する際によくある質問への回答です。
一般的なユースケースには、会議メモ、インタビューの文字起こし、字幕、サポート通話のレビュー、調査コーディング、検索可能な音声アーカイブなどがあります。最も効果的なワークフローでは、自動文字起こしに、重要または機密性の高い内容のレビュー工程を組み合わせます。
Whisper 音声認識自体は音声認識を行いますが、話者識別やダイアライゼーションは通常、追加のプロセスで処理します。話者の帰属が重要な場合は、文字起こしを共有する前に、各ラベルを録音と照合して確認してください。
十分に質の高い初稿を作成できますが、精度は音質、アクセント、音声の重なり、専門用語、固有名詞によって変わります。引用、数値、法律または医療に関する表現、意味が変わる可能性のある箇所は、人が確認する必要があります。
利用可能な中で最も明瞭な音源を使用し、周囲の雑音を抑え、音声の重なりを最小限にしてください。元の録音、言語のコンテキスト、有用なタイムスタンプを保持すると、エラーの調査と修正が容易になります。
処理環境、アクセス制御、同意要件、保持ポリシーを確認した後にのみ実施してください。文字起こしによって機密情報が検索しやすくなる可能性があるため、元の録音に適用しているものと同等以上の保護対策を講じてください。