Whisper 音声認識は単語レベルのタイミングを保証しない
基本的なWhisper 音声認識の出力では通常、セグメント単位のタイムスタンプが提供されます。そのため、字幕、カラオケのようなハイライト表示、正確な編集には範囲が広すぎる場合があります。
回避策
個々の単語を音声に近い形で対応付ける必要がある場合は、WhisperXのアライメントを使用します。
比較ガイド
信頼性の高い文字起こしが必要か、それともより充実した後処理ワークフローが必要かによって答えは異なります。このガイドでは、アライメント、タイムスタンプ、話者ラベル、セットアップの手間、日常的な使い方という観点から、Whisper 音声認識とWhisperXを比較します。
重要なのは、すべてに通用する勝者を選ぶことではなく、次の作業で実際に必要となる出力に合ったものを選ぶことです。
Whisper 音声認識とWhisperXは文字起こしの基盤を共有していますが、音声ワークフローの異なるレイヤーを解決します。
基本的なWhisper 音声認識の出力では通常、セグメント単位のタイムスタンプが提供されます。そのため、字幕、カラオケのようなハイライト表示、正確な編集には範囲が広すぎる場合があります。
回避策
個々の単語を音声に近い形で対応付ける必要がある場合は、WhisperXのアライメントを使用します。
アライメントでタイミングを細かく調整できるのは、音声が認識された後だけです。複数話者の重なり、音楽、音割れ、強い訛りによって、誤った単語が生成される可能性は依然としてあります。
回避策
録音をクリアにし、可能な場合は話者を分離して、信頼度の低い箇所を確認します。
話者ダイアライゼーションは追加の段階であり、文字起こしに備わる魔法のような機能ではありません。重なり合う音声や短い発話の切り替わりによって、話者の割り当てを誤ることがあります。
回避策
ダイアライゼーションは編集可能な下書きとして扱い、録音を聞いて名前を確認してください。
モデルをローカルで実行するには、適切なハードウェア、依存関係、ストレージ、そしてセットアップのための時間が必要です。Webインターフェースではその作業の多くが隠されていますが、自由に制御できる範囲は狭くなります。
回避策
目的に合った環境を選びましょう。制御性を重視するならローカル処理、すぐに結果を得たいならガイド付きワークフローが適しています。
どちらのワークフローでも、1つの文字起こしを最終的な真実とみなすのではなく、認識、アライメント、解釈を分けて考えると、結果を判断しやすくなります。
まず音声から始め、文字起こしの下書きを作成します。Whisper 音声認識は音声をテキストに変換することに優れていますが、句読点、名前、数字、ノイズの多い部分については、引き続き確認が必要です。
タイミングが重要な場合は、文字起こしをアライメント段階にかけます。WhisperXは強制アライメントを使用して、波形に対して単語をより正確に配置します。
話者の識別が重要な場合にのみダイアライゼーションを適用し、その後、字幕、メモ、引用、検索可能なテキストとしてエクスポートする前に、文字起こしを確認します。
これらの数値は意思決定の全体像を示すものであり、どの録音でも1つのパイプラインが必ず勝つことを保証するものではありません。
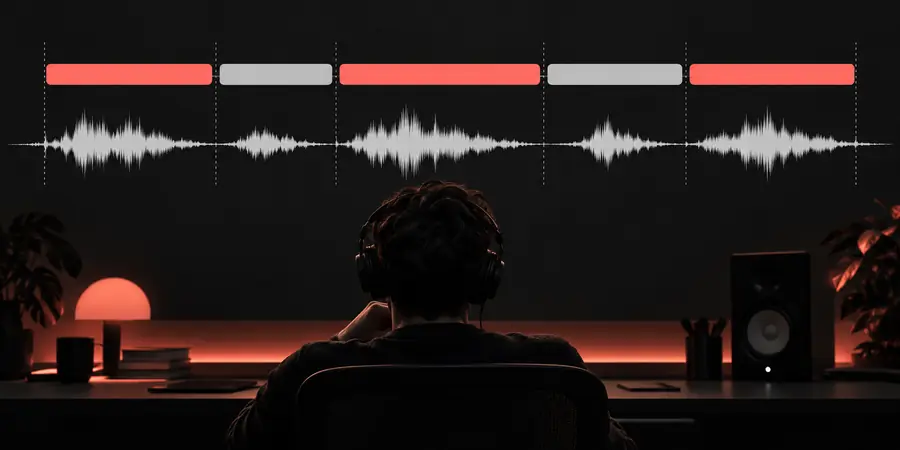 セグメントトランスクリプト
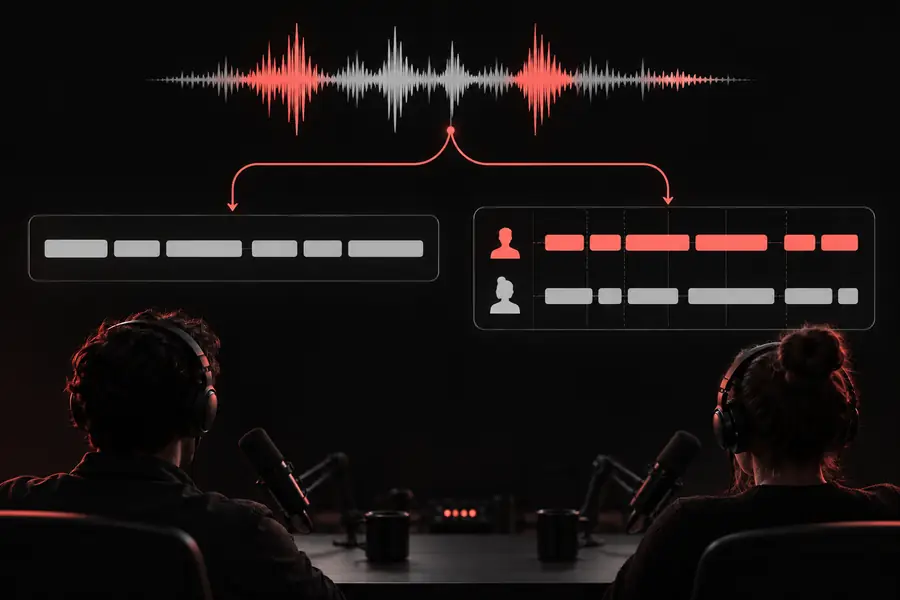 アライン済みトランスクリプト
ツール名だけでなく、引き継ぎ、編集、公開に必要な出力に基づいて選びましょう。
聞き取りやすく、ほぼ1人で話している録音から、読みやすいトランスクリプトと検索可能な引用を作成したい。
よりシンプルな処理手順としてWhisper 音声認識から始め、名前、句読点、引用の正確さにレビュー時間を使いましょう。
Whisper 音声認識 vs transcribe字幕やタイミング付きクリップ用に、話されたタイミングに近い形で単語を表示したい。
認識にはWhisper 音声認識を使い、キャプションファイルを仕上げる前にWhisperX形式のアラインメントを追加しましょう。
Whisper 音声認識 vs deepgramインタビューをローカルで処理し、ファイル、モデル、再現可能なスクリプトを管理したい。
Whisper 音声認識は実用的な基盤です。調査成果物で必要な場合にのみ、アラインメントと話者ダイアライゼーションを追加しましょう。
Whisper 音声認識のオープンソース代替話者の交代を含む簡単な下書きが欲しい一方で、部屋には割り込みや声の重なりがある。
レビューなしでどちらの結果も受け入れるべきではありません。話者の分離によって追加の複雑さが正当化される場合にのみ、より高度な処理パイプラインを使いましょう。
Whisper 音声認識 vs deepgram正確な下書きテキストと管理しやすいローカルワークフローを優先するなら、Whisper 音声認識を使いましょう。単語レベルのタイミング、話者を考慮したレビュー、または追加の処理と検証に見合うキャプションのアラインメントが必要なら、WhisperXを追加します。
Whisper 音声認識をオンラインで試す以下の簡潔な回答では、2つの名称が共通する部分と、それぞれのワークフローが異なる部分を明確にします。
Whisper 音声認識は音声認識モデルであり、初期トランスクリプトを生成します。WhisperXはそのような文字起こしを基盤に、より正確な単語レベルのタイムスタンプや、ワークフローによっては話者ダイアライゼーションを実現する追加処理を行います。
最も簡単な意味では、そうではありません。WhisperXは、一般的にWhisper 音声認識を認識処理に使用し、その後にアライメントやオプションの話者処理ステージを追加するワークフローおよびツールセットと考えるのが適切です。
大まかなセグメントのタイミングで問題ない場合、Whisper 音声認識は実用的な字幕の下書きを作成できます。字幕により正確な単語単位のタイミングが必要な場合は、通常WhisperXのほうが適していますが、認識エラーや話者の重なりについては、結果を確認する必要があります。
主な利点は、認識されたすべての単語を自動的に修正することではなく、タイミングのアライメントにあります。トランスクリプトの同期や編集を容易にする可能性はありますが、単語の正確さには、元の音声品質と認識処理の結果も依然として大きく影響します。
通常は必要ありません。読みやすいテキスト、メモ、検索、または大まかな引用が必要な場合は、Whisper 音声認識のトランスクリプトで十分なことがあります。アライメント、話者ダイアライゼーション、または細かくタイミング調整された字幕が成果物の中心となる場合は、追加のワークフローを選択してください。