Whisperai

Guia de comparação

quais são, na prática, as principais diferenças entre a transcrição do Whisper e o WhisperX?

A resposta depende de você precisar de uma transcrição confiável ou de um fluxo de pós-processamento mais completo. Este guia compara o Whisper e o WhisperX em alinhamento, marcações de tempo, identificação de locutores, esforço de configuração e uso cotidiano.

5
Tamanhos dos modelos originais do Whisper
30 sec
Janela de áudio normalmente usada pelo Whisper
99
Idiomas compatíveis com o modelo original
Forma de onda de áudio abstrata representando a transcrição de fala

Três cenários reais, uma escolha para cada um

A escolha certa tem menos a ver com um vencedor universal e mais com o resultado de que sua próxima tarefa realmente precisa.

Matriz de recursos

O Whisper e o WhisperX compartilham uma base de transcrição, mas resolvem camadas diferentes do fluxo de trabalho de áudio.

O Whisper não garante marcação de tempo em nível de palavra

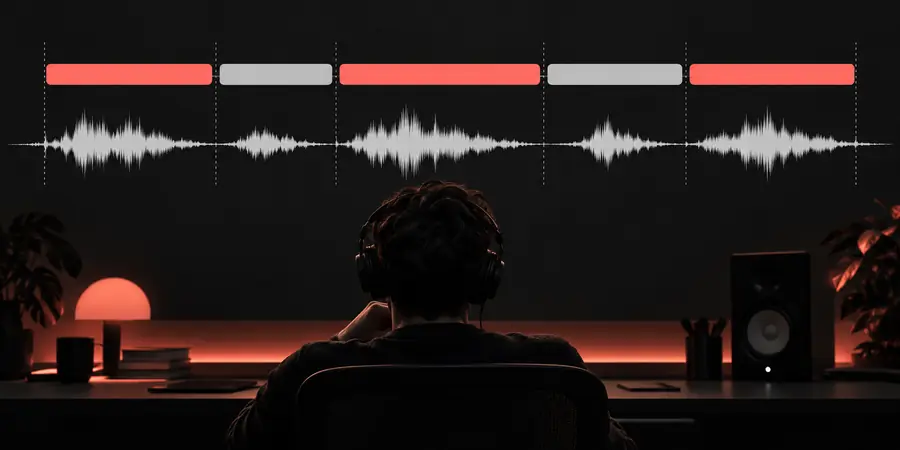
A saída básica do Whisper geralmente fornece marcações de tempo em nível de segmento, que podem ser amplas demais para legendas, realce no estilo karaokê ou edição precisa.

Solução alternativa

Use o alinhamento do WhisperX quando palavras individuais precisarem ser mapeadas de perto ao áudio.
O WhisperX não elimina os problemas de áudio com ruído

O alinhamento só pode refinar a marcação de tempo depois que a fala for reconhecida. Falas sobrepostas, música, clipping e sotaques fortes ainda podem produzir palavras incorretas.

Solução alternativa

Limpe a gravação, separe os locutores sempre que possível e revise os trechos com baixa confiança.

Nenhuma das duas ferramentas conhece automaticamente todos os locutores

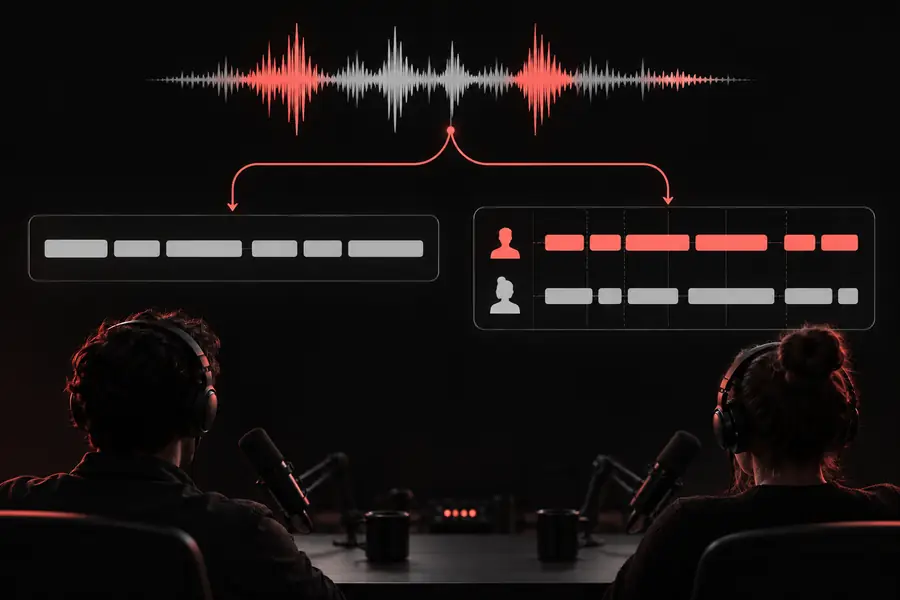
A diarização de locutores é uma etapa adicional, não uma propriedade mágica da transcrição. Vozes sobrepostas e falas curtas podem confundir a atribuição dos locutores.

Solução alternativa

Trate a diarização como um rascunho editável e verifique os nomes na gravação.

Um fluxo de trabalho no navegador não é o mesmo que uma inferência local

Executar um modelo localmente requer hardware adequado, dependências, armazenamento e tempo para configuração. Uma interface web oculta grande parte desse trabalho, mas oferece menos controle.

Solução alternativa

Escolha a superfície que corresponde à tarefa: processamento local para ter controle, um fluxo guiado para obter resultados rápidos.

Armadilhas comuns

É mais fácil avaliar ambos os fluxos quando você separa reconhecimento, alinhamento e interpretação, em vez de tratar uma única transcrição como a verdade final.

  1. 1

    Transcreva a gravação

    Comece com o áudio e produza uma transcrição preliminar. A transcrição do Whisper é eficiente para transformar fala em texto, mas a pontuação, os nomes, os números e os trechos ruidosos ainda merecem revisão.

  2. 2

    Alinhe as palavras reconhecidas

    Se o tempo for importante, passe a transcrição por uma etapa de alinhamento. O WhisperX usa alinhamento forçado para posicionar as palavras com mais precisão em relação à forma de onda.

  3. 3

    Revise os locutores e exporte

    Aplique a diarização somente quando a identidade dos locutores for importante e, em seguida, confira a transcrição antes de exportar legendas, anotações, citações ou texto pesquisável.

Nosso equilíbrio

Esses números descrevem o formato da decisão, não uma promessa de que um pipeline vencerá em todas as gravações.

A família de modelos original da transcrição do Whisper, do tiny ao large
5 tamanhos
Contexto de áudio aproximado usado pela abordagem original da transcrição do Whisper
30 segundos
Idiomas informados para o modelo multilíngue original da transcrição do Whisper
99 idiomas
Um fluxo de trabalho comum do WhisperX: reconhecimento seguido de alinhamento
2 etapas
Comparação de transcrições mostrando a temporização ampla dos segmentos Transcrição segmentada
Comparação de transcrições mostrando uma temporização mais precisa por palavra Transcrição alinhada
A diferença visível está na precisão do tempo, não na garantia de palavras perfeitas.

Onde cada fluxo de trabalho se justifica

Escolha com base no resultado que você precisa entregar, editar ou publicar — não apenas no nome da ferramenta.

Editor de podcast

Você precisa de uma transcrição legível e de citações pesquisáveis a partir de uma gravação limpa, em sua maior parte com um único locutor.

Comece com a transcrição do Whisper para um fluxo mais simples e depois dedique o tempo de revisão a nomes, pontuação e precisão das citações.

transcrição do Whisper vs transcrição

Produtor de legendas

Você precisa que as palavras apareçam próximas do momento em que foram pronunciadas para legendas ou clipes sincronizados.

Use a transcrição do Whisper para o reconhecimento e adicione um alinhamento no estilo do WhisperX antes de aperfeiçoar o arquivo de legendas.

transcrição do Whisper vs deepgram

Equipe de pesquisa

Você processa entrevistas localmente e quer ter controle sobre arquivos, modelos e scripts reproduzíveis.

A transcrição do Whisper é uma base prática; adicione alinhamento e diarização apenas onde o resultado da pesquisa exigir.

alternativas de código aberto à transcrição do Whisper

Fluxo de trabalho para anotações de reuniões

Você quer um rascunho rápido com turnos de fala, mas a sala contém interrupções e vozes sobrepostas.

Nenhum dos resultados deve ser aceito sem revisão; use o fluxo mais completo apenas se a separação dos locutores justificar a complexidade adicional.

transcrição do Whisper vs deepgram

Escolha o resultado antes de escolher a pilha

Use a transcrição do Whisper quando texto preliminar preciso e um fluxo de trabalho local gerenciável forem prioridade. Adicione o WhisperX quando a marcação de tempo por palavra, a revisão com identificação dos locutores ou o alinhamento de legendas compensarem o processamento e a verificação adicionais.

Experimente a transcrição do Whisper online
  • Texto preliminar primeiro, marcação de tempo depois
  • Revise nomes, números e alternâncias entre os participantes
  • Mantenha uma gravação original limpa

FAQ de comparação

As respostas curtas abaixo esclarecem onde os dois nomes se sobrepõem e onde seus fluxos de trabalho divergem.

A transcrição do Whisper é o modelo de reconhecimento de fala e produz a transcrição inicial. O WhisperX se baseia nesse tipo de transcrição com processamento adicional para obter marcações de tempo mais precisas em nível de palavra e, em alguns fluxos de trabalho, diarização dos participantes.

Não no sentido mais simples. É melhor entender o WhisperX como um fluxo de trabalho e um conjunto de ferramentas que normalmente usa a transcrição do Whisper para o reconhecimento e, em seguida, adiciona etapas de alinhamento e processamento opcional dos participantes.

A transcrição do Whisper pode criar um rascunho útil de legendas, especialmente quando uma temporização ampla dos segmentos é aceitável. O WhisperX geralmente é mais adequado quando as legendas precisam de uma temporização mais precisa por palavra, mas o resultado ainda precisa ser verificado quanto a erros de reconhecimento e sobreposição de falas.

Sua principal vantagem é o alinhamento temporal, e não a correção automática de todas as palavras reconhecidas. Ele pode facilitar a sincronização e a edição da transcrição, enquanto a qualidade do áudio original e a etapa de reconhecimento continuam influenciando fortemente a precisão das palavras.

Geralmente, não. Se você precisa de texto legível, anotações, pesquisa ou citações aproximadas, uma transcrição do Whisper pode ser suficiente; escolha o fluxo de trabalho adicional quando o alinhamento, a diarização ou as legendas com temporização precisa forem essenciais para a entrega.

Começar a transcrever