Conheça a transcrição do Whisper, reconhecimento de fala feito para vozes reais
Um olhar claro sobre a transcrição do Whisper, a rede neural aberta que transcreve e traduz fala com precisão quase humana, mesmo com sotaques, ruído e jargão.
Este guia aborda a transcrição do Whisper conforme lançada inicialmente em 2022.
Precisa de uma ferramenta pronta para áudio e transcrições hoje?
Abrir o transcritorExemplos da transcrição do Whisper:
“Okay, the shipment lands Tuesday, the invoice goes out Wednesday, and if anyone asks, the demo moves to Friday at nine sharp.”
“We grew up near the harbour, and every summer my grandfather took us out on his little fishing boat before sunrise.”
“Sorry, it is loud in here. Can you hear me? I said the Whisper notes are in the shared folder now.”
[Francês para inglês] “I would like to book two tickets for the Saturday night concert, please.”
A transcrição do Whisper é um modelo de reconhecimento de fala que aprendeu com 680,000 horas de áudio rotulado, abrangendo muitos idiomas e tarefas, coletadas em toda a web aberta. Essa amplitude compensa: o modelo lida com sotaques, conversas de fundo e vocabulário técnico muito melhor do que sistemas treinados de forma restrita. Ele transcreve dezenas de idiomas e pode convertê-los para o inglês. Os pesos e o código de inferência são divulgados abertamente, para que equipes possam criar produtos reais com a transcrição do Whisper e pesquisadores possam continuar avançando o processamento de fala robusto.
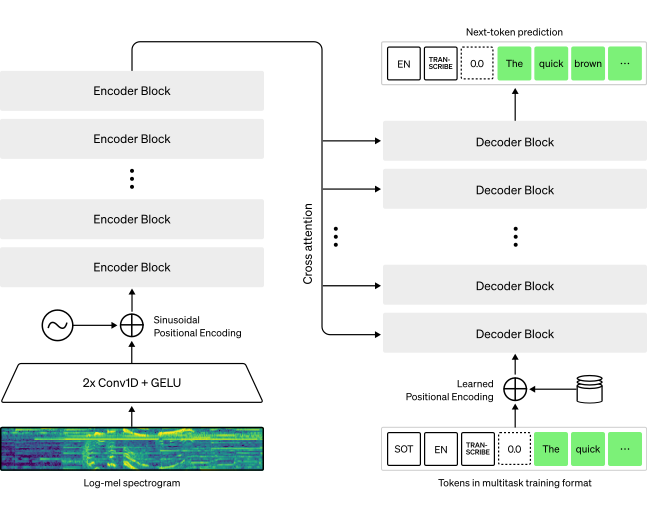
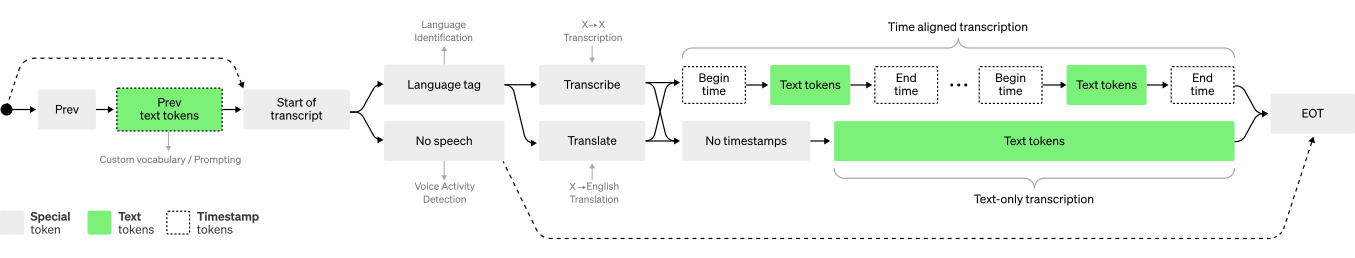
Por baixo dos panos, a transcrição do Whisper é um Transformer codificador-decodificador simples, treinado de ponta a ponta. O áudio de entrada é cortado em janelas de 30 segundos e transformado em um espectrograma log-Mel antes de chegar ao codificador. O decodificador então prevê o texto correspondente, misturado com tokens especiais que dizem a um único modelo compartilhado qual tarefa executar: detectar o idioma, marcar cada frase com tempos, transcrever em vários idiomas ou traduzir fala para o inglês.
Muitos sistemas anteriores se apoiam em conjuntos de dados menores, nos quais áudio e texto são estreitamente alinhados,1 2, 3 ou em enormes corpora de áudio não rotulado usados para pré-treinamento.4, 5, 6 Como a transcrição do Whisper viu um conjunto de dados amplo e variado e nunca foi ajustada para um único benchmark, ela não supera os modelos especialistas no LibriSpeech, a régua clássica da área. No entanto, testada em zero-shot em muitos outros conjuntos de dados, a transcrição do Whisper se mostra muito mais robusta e comete cerca de metade dos erros.
Cerca de um terço do áudio de treinamento da transcrição do Whisper não está em inglês. Para esses clipes, pede-se ao modelo que escreva o idioma de origem ou o traduza para o inglês. Essa mistura acaba ensinando tradução de fala para texto notavelmente bem, superando o estado da arte supervisionado no CoVoST2 para inglês sem nenhum treinamento específico para a tarefa.
Transcrição em inglês
Qualquer idioma para inglês
Transcrição de idiomas não ingleses
Sem fala
Pares de treinamento da transcrição do Whisper: áudio de entrada, texto de saída
Esperamos que a precisão e a simplicidade da transcrição do Whisper coloquem a entrada de voz ao alcance de muito mais aplicativos. Revisite as fontes, o diagrama do modelo e as amostras de dados para o panorama completo e, em seguida, transforme suas próprias gravações em texto.
Fontes
- 1
Chan et al. SpeechStew: reunindo todos os conjuntos de dados de fala disponíveis para treinar uma grande rede. arXiv 2104.02133, 2021.
- 2
Galvez et al. The People’s Speech: um corpus de inglês grande e variado liberado para uso comercial. arXiv 2111.09344, 2021.
- 3
Chen et al. GigaSpeech: um corpus multidomínio com 10.000 horas de áudio transcrito. arXiv 2106.06909, 2021.
- 4
Baevski, Zhou, Mohamed e Auli. wav2vec 2.0: aprendizado autossupervisionado de características de fala. arXiv 2006.11477, 2020.
- 5
Baevski, Hsu, Conneau e Auli. Reconhecimento de fala sem rótulos. NeurIPS 34, 2021.
- 6
Zhang et al. BigSSL: ampliando o aprendizado semissupervisionado para reconhecimento de fala. arXiv 2109.13226, 2021.