Whisperai

Vergleichsleitfaden

Was sind in der Praxis die wichtigsten Unterschiede zwischen Whisper-Transkription und WhisperX?

Die Antwort hängt davon ab, ob Sie eine zuverlässige Transkription oder einen umfassenderen Workflow für die Nachbearbeitung benötigen. Dieser Leitfaden vergleicht Whisper-Transkription und WhisperX hinsichtlich Alignment, Zeitstempeln, Sprecherkennzeichnung, Einrichtungsaufwand und alltäglicher Nutzung.

5
Größen der ursprünglichen Whisper-Transkriptionsmodelle
30 Sek.
Typisches Audiofenster, das von Whisper-Transkription verwendet wird
99
Vom ursprünglichen Modell unterstützte Sprachen
Abstrakte Audiowellenform zur Darstellung einer Sprachtranskription

Drei reale Szenarien, jeweils eine Auswahl

Die richtige Wahl hängt weniger von einem universellen Sieger ab, sondern vielmehr davon, welche Ausgabe Ihre nächste Aufgabe tatsächlich benötigt.

Fähigkeitsmatrix

Whisper-Transkription und WhisperX teilen sich eine Grundlage für die Transkription, lösen aber unterschiedliche Ebenen des Audio-Workflows.

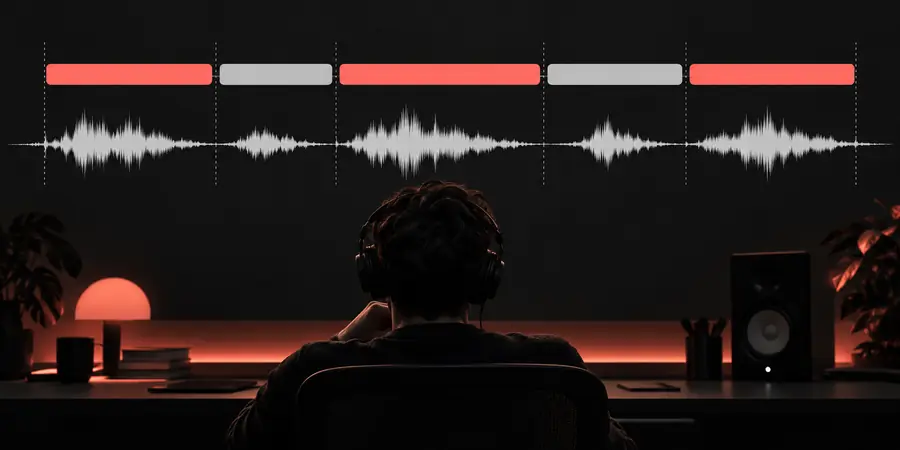
Whisper-Transkription garantiert keine zeitliche Zuordnung auf Wortebene

Die Ausgabe der grundlegenden Whisper-Transkription enthält üblicherweise Zeitstempel auf Segmentebene, die für Untertitel, Karaoke-ähnliche Hervorhebungen oder präzise Bearbeitung zu ungenau sein können.

Workaround

Verwenden Sie das Alignment von WhisperX, wenn einzelne Wörter möglichst genau dem Audio zugeordnet werden müssen.
WhisperX beseitigt keine Probleme mit verrauschtem Audio

Das Alignment kann die zeitliche Zuordnung erst verfeinern, nachdem die Sprache erkannt wurde. Überschneidende Sprache, Musik, Clipping und starke Akzente können weiterhin zu falschen Wörtern führen.

Workaround

Bereinigen Sie die Aufnahme, trennen Sie Sprecher nach Möglichkeit und überprüfen Sie Passagen mit geringer Konfidenz.

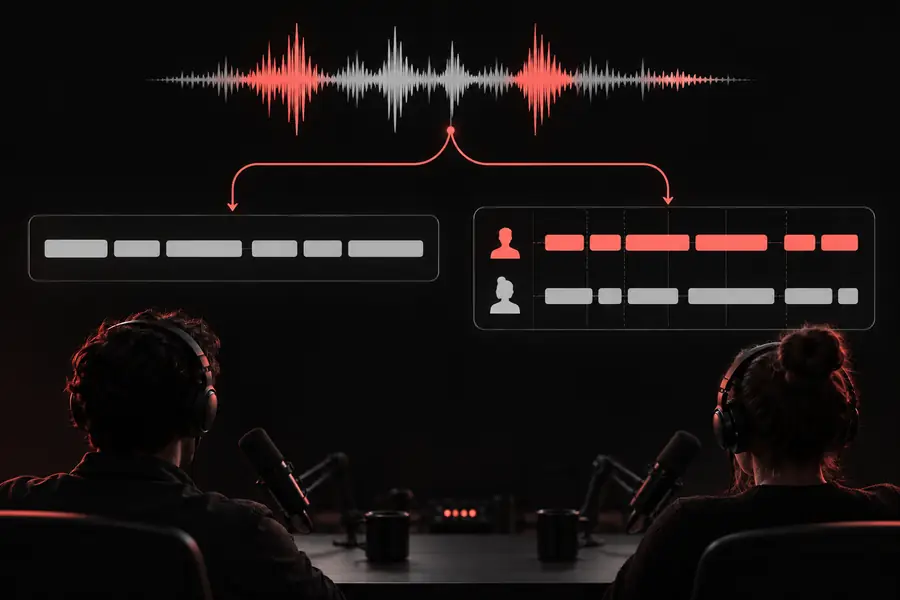
Keines der beiden Tools kennt automatisch jeden Sprecher

Die Sprecherdiarisierung ist eine zusätzliche Phase und keine magische Eigenschaft der Transkription. Überlappende Stimmen und kurze Sprecherwechsel können die Zuordnung der Sprecher erschweren.

Behelfslösung

Betrachten Sie die Diarisierung als bearbeitbaren Entwurf und überprüfen Sie die Namen anhand der Aufnahme.

Ein browserbasierter Workflow ist nicht dasselbe wie lokale Inferenz

Die lokale Ausführung eines Modells erfordert geeignete Hardware, Abhängigkeiten, Speicherplatz und Zeit für die Einrichtung. Eine Weboberfläche nimmt Ihnen einen Großteil dieser Arbeit ab, bietet Ihnen aber weniger Kontrolle.

Behelfslösung

Wählen Sie die Oberfläche, die zur Aufgabe passt: lokale Verarbeitung für Kontrolle, ein geführter Workflow für schnelle Ergebnisse.

Gemeinsame Fallstricke

Beide Workflows lassen sich leichter beurteilen, wenn Sie Erkennung, Alignment und Interpretation voneinander trennen, anstatt ein einzelnes Transkript als endgültige Wahrheit zu betrachten.

  1. 1

    Die Aufnahme transkribieren

    Beginnen Sie mit dem Audio und erstellen Sie ein Transkript als Entwurf. Die Whisper-Transkription ist stark darin, Sprache in Text umzuwandeln, aber Zeichensetzung, Namen, Zahlen und verrauschte Passagen sollten weiterhin überprüft werden.

  2. 2

    Die erkannten Wörter ausrichten

    Wenn das Timing wichtig ist, führen Sie das Transkript durch eine Alignment-Phase. WhisperX verwendet Forced Alignment, um Wörter präziser an der Wellenform zu positionieren.

  3. 3

    Sprecher überprüfen und exportieren

    Wenden Sie die Diarisierung nur an, wenn die Identität der Sprecher wichtig ist, und überprüfen Sie anschließend das Transkript, bevor Sie Untertitel, Notizen, Zitate oder durchsuchbaren Text exportieren.

Unser Kompromiss

Diese Zahlen beschreiben die Form der Entscheidung, sind aber kein Versprechen, dass eine Pipeline bei jeder Aufnahme gewinnt.

Die ursprüngliche Modellfamilie der Whisper-Transkription, von tiny bis large
5 Größen
Ungefährer Audiokontext, der vom ursprünglichen Ansatz der Whisper-Transkription verwendet wird
30 Sekunden
Für das ursprüngliche mehrsprachige Modell der Whisper-Transkription angegebene Sprachen
99 Sprachen
Ein gängiger WhisperX-Workflow: Erkennung gefolgt von Alignment
2 Phasen
Transkriptvergleich mit grober Segmentzeitplanung Segment-Transkript
Transkriptvergleich mit präziserer Wortzeitplanung Ausgerichtetes Transkript
Der sichtbare Unterschied liegt in der Präzision des Timings, nicht in einer Garantie für perfekte Wörter.

Wo jeder Workflow seine Berechtigung hat

Wählen Sie nach dem Output, den Sie übergeben, bearbeiten oder veröffentlichen müssen – nicht allein nach dem Namen des Tools.

Podcast-Editor

Sie benötigen ein lesbares Transkript und durchsuchbare Zitate aus einer sauberen Aufnahme mit größtenteils nur einer sprechenden Person.

Beginnen Sie mit der Whisper-Transkription für eine einfachere Pipeline und verwenden Sie anschließend die Prüfzeit auf Namen, Zeichensetzung und die Genauigkeit von Zitaten.

Whisper-Transkription vs. Transkription

Untertitelproduzent

Sie möchten, dass Wörter für Untertitel oder zeitgesteuerte Clips möglichst nah an ihrem gesprochenen Timing erscheinen.

Verwenden Sie die Whisper-Transkription zur Erkennung und fügen Sie vor der abschließenden Bearbeitung der Untertiteldatei eine Ausrichtung im Stil von WhisperX hinzu.

Whisper-Transkription vs. Deepgram

Forschungsteam

Sie verarbeiten Interviews lokal und möchten Kontrolle über Dateien, Modelle und wiederholbare Skripte haben.

Die Whisper-Transkription ist eine praktische Grundlage; fügen Sie Ausrichtung und Sprechererkennung nur dort hinzu, wo das Forschungsergebnis sie benötigt.

Open-Source-Alternativen zur Whisper-Transkription

Workflow für Besprechungsnotizen

Sie möchten einen schnellen Entwurf mit Sprecherwechseln, aber im Raum gibt es Unterbrechungen und überlappende Stimmen.

Keines der Ergebnisse sollte ohne Prüfung übernommen werden; verwenden Sie die umfangreichere Pipeline nur, wenn die Trennung der Sprecher die zusätzliche Komplexität rechtfertigt.

Whisper-Transkription vs. Deepgram

Wählen Sie zuerst den Output, dann den Stack

Verwenden Sie die Whisper-Transkription, wenn genauer Entwurfstext und ein überschaubarer lokaler Workflow Priorität haben. Fügen Sie WhisperX hinzu, wenn Timing auf Wortebene, eine sprecherbezogene Prüfung oder die Ausrichtung von Untertiteln den zusätzlichen Verarbeitungs- und Prüfaufwand rechtfertigt.

Whisper online ausprobieren
  • Zuerst der Entwurfstext, dann das Timing
  • Namen, Zahlen und Sprecherwechsel überprüfen
  • Eine saubere Originalaufnahme beibehalten

FAQ zum Vergleich

Die kurzen Antworten unten erläutern, wo sich die beiden Namen überschneiden und in welchen Punkten sich ihre Workflows unterscheiden.

Whisper-Transkription ist das Spracherkennungsmodell und erstellt die erste Transkription. WhisperX baut auf dieser Art der Transkription auf und ergänzt sie um eine zusätzliche Verarbeitung für präzisere Zeitstempel auf Wortebene sowie in einigen Workflows um eine Sprecherdiarisierung.

Nicht im einfachsten Sinne. WhisperX lässt sich am besten als Workflow und Toolset verstehen, das für die Erkennung häufig Whisper-Transkription verwendet und anschließend Ausrichtungs- sowie optionale Schritte zur Sprecherverarbeitung ergänzt.

Whisper-Transkription kann einen brauchbaren Untertitelentwurf erstellen, insbesondere wenn eine grobe Segmentzeitplanung ausreicht. WhisperX eignet sich in der Regel besser, wenn Untertitel eine präzisere Wortzeitsteuerung benötigen. Das Ergebnis muss jedoch weiterhin auf Erkennungsfehler und Überschneidungen zwischen Sprechern überprüft werden.

Der Hauptvorteil liegt in der zeitlichen Ausrichtung und nicht in der automatischen Korrektur jedes erkannten Wortes. Die Transkription lässt sich dadurch möglicherweise leichter synchronisieren und bearbeiten, während die zugrunde liegende Audioqualität und der Erkennungsvorgang weiterhin großen Einfluss auf die Wortgenauigkeit haben.

In der Regel nicht. Wenn Sie lesbaren Text, Notizen, eine Suchfunktion oder grobe Zitate benötigen, reicht eine Whisper-Transkription möglicherweise aus. Wählen Sie den erweiterten Workflow, wenn Ausrichtung, Diarisierung oder präzise zeitgesteuerte Untertitel im Mittelpunkt des Ergebnisses stehen.

Transkription starten