インタビュアー
会話を録音し、最初の文字起こしを読みやすい回答、引用、追加質問に変換できます。
音声を何度も探しながら再生する時間を減らし、ストーリーの構成により多くの時間を使えます。
Whisper 音声認識ノート音声からテキストへ
Whisper 音声認識の文字起こしは、録音した音声を読みやすいテキストに変換します。すべての時間を再生し直さなくても、アイデアを振り返り、重要な場面を見つけ、メモを作成できます。
ブラウザベースのツールから、より技術的な音声テキスト変換の方法まで、ワークフローに最適な選択肢を選べます。
同じ音声からテキストへの変換プロセスでも、さまざまな作業に対応できます。ただし、役立つ成果物とは常に、検索、編集、再利用がしやすいテキストです。
会話を録音し、最初の文字起こしを読みやすい回答、引用、追加質問に変換できます。
音声を何度も探しながら再生する時間を減らし、ストーリーの構成により多くの時間を使えます。
Whisper 音声認識ノート講義、フィールド録音、口頭での観察記録を処理し、元の音声と照らし合わせて確認できる下書きに変換します。
元の録音を検証用に保ちながら、検索可能な研究記録を作成できます。
Whisper 音声認識 STTポッドキャスト、ウェビナー、インタビューを、記事、キャプション、番組ノートの編集可能な基盤に変換できます。
録音から、手作業の工程を減らして再利用可能な編集用下書きへ移行します。
openai Whisper 音声認識の例話し合いの内容を記録し、文字起こしを決定事項、質問、次のアクションに整理します。
記憶だけに頼らず、長い会話を後から簡単に振り返れるようにします。
Whisper 音声認識 オンライン文字起こしを単一のボタン操作ではなく、短いパイプラインとして扱うことで、信頼できる結果が得られます。
利用可能な中で最も明瞭な音声を使い、可能であれば不要な無音部分をトリミングし、処理前にファイルが正しく開くことを確認します。
モデルが音声を分析し、話されている言語を識別して、初回の文字起こし結果を生成します。ノイズの多い部分は、再度確認が必要になる場合があります。
録音を確認しながら、人名、句読点、曖昧なフレーズを修正し、整えたテキストをメモ、字幕、または下書きに仕上げます。
自動生成された出力は、最終的な編集済み文書ではなく、優れた出発点です。簡単に比較するだけでも、人による確認が必要な箇所がわかります。
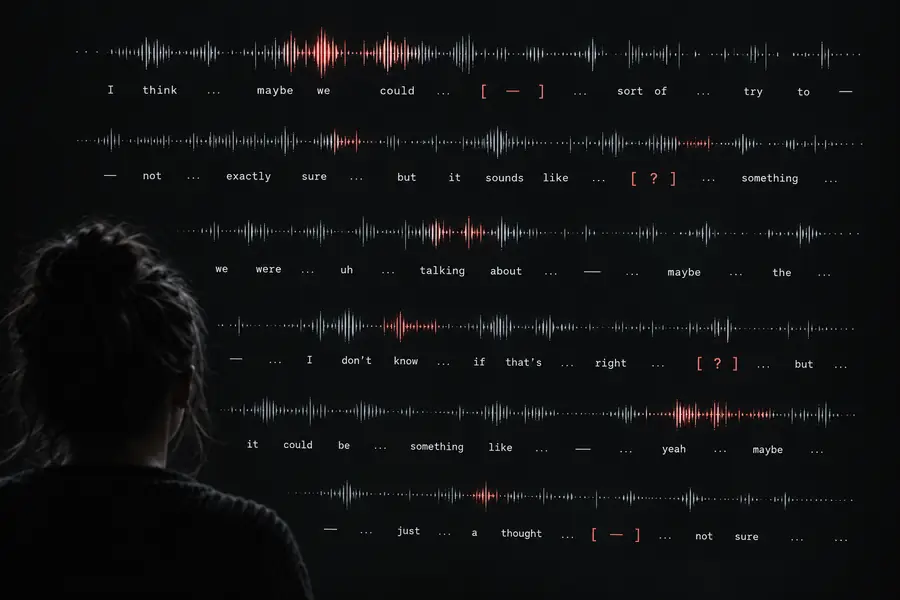 初回処理
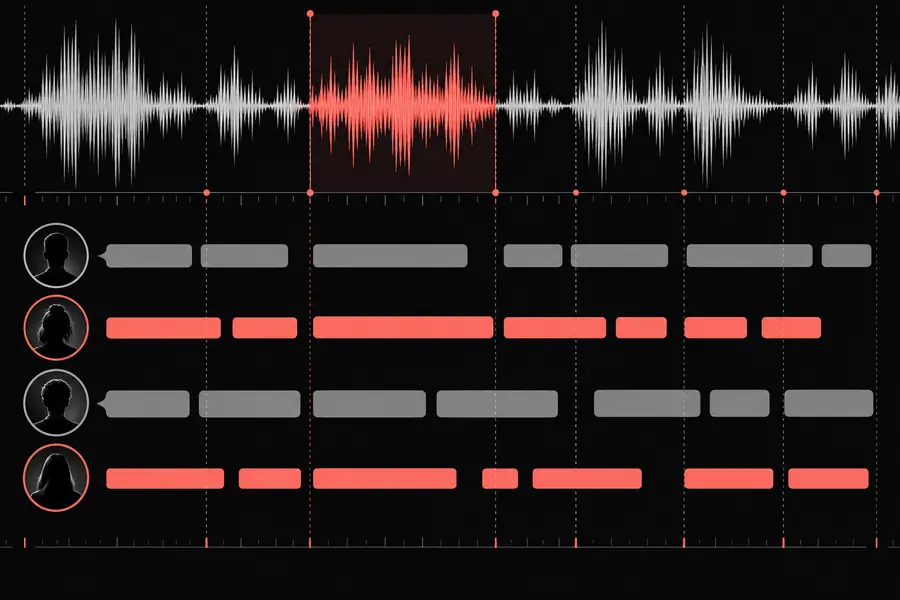 確認済みの出力
文字起こしによって元の録音が変わることはありません。内容を確認して変換しやすくするテキストレイヤーが追加されます。
主な形式
音声録音
音声録音
文字起こし
検索可能なテキスト
確認方法
音声録音
タイムスタンプから聴く
文字起こし
スキャン、検索、閲覧
話者の意味
音声録音
声のトーンと話し方を保持
文字起こし
認識された単語として表現
編集
音声録音
音声ソフトウェアまたは録り直しが必要
文字起こし
通常のテキストとして修正可能
正確性の確認
音声録音
検証用の元データ
文字起こし
音声が不明瞭な箇所では比較が必要
最適な用途
音声録音
ニュアンス、強調、保存用の原資料
文字起こし
メモ、下書き、キャプション、探索
主なリスク
音声録音
重要な瞬間を見つけにくい
文字起こし
名前や専門用語が誤認識される可能性がある
これらの基準点は、基盤となる音声認識アプローチの適用範囲を示すものであり、すべての録音が同じ精度で認識されることを保証するものではありません。
有用な文字起こしは、現実的な期待から始まります。音声、言語、または求められる出力が、自動処理で確実に提供できる範囲を超える可能性がある箇所は次のとおりです。
音割れ、強い背景雑音、声の重なり、遠距離のマイクによって、正確な文言に必要な手がかりが失われることがあります。
回避策
可能であれば録音を改善し、チャンネルを分離して、確認時に不確かな箇所を再生してください。
文字起こしでは発言内容を捉えられても、特に会話が速かったり発言が重なったりすると、各行を誰が話したのかを一貫して特定できない場合があります。
対処法
話者の既知の順番を利用し、手動でラベルを追加するか、ワークフローで対応している場合は別々のチャンネルに録音します。
人名、地名、製品名、頭字語、一般的でない語彙は、もっともらしく見えても綴りが間違っている形で出力される可能性が高くなります。
対処法
用語リストを用意し、考えられる誤りを検索して、重要な用語を元の音声と照合します。
生の出力には、繰り返し、言いよどみ、句読点の欠落、自然な文章とは異なる表現が含まれる場合があります。
対処法
最後に、不要な部分の整理、書式設定、引用、正確な文言が必要な主張の確認に時間を取ります。
Whisperai に音声タスクを送信し、最初の文字起こしをメモ、調査、字幕、編集作業に使える実用的な下書きとして活用しましょう。重要な詳細を確認できるよう、元の録音は手元に置いておきます。
今すぐ音声を文字起こしする録音をテキストに変換する前に知っておきたい、実用的な回答をいくつか紹介します。
話し言葉の音声を、検索、編集、要約、または別の用途に活用できるテキストへ変換するために使われます。一般的な用途には、インタビュー、会議、講義、ポッドキャスト、字幕、調査メモなどがあります。
Whisper 音声認識は、多言語の音声認識に対応するよう設計されており、幅広い言語をサポートしています。ただし、結果は音声の品質、アクセント、語彙、コードスイッチング、話者の録音の明瞭さなどに左右されます。
精度はすべてのファイルで一定ではなく、録音環境によって変わります。明瞭な発話で発言の重なりが少ない場合は、より質の高い初稿が得られる傾向があります。一方、ノイズ、人名、専門用語、発言の重なりがある場合は、より綿密な確認が必要です。
音声認識では発話内容を文字にできますが、すべての発言を正確に話者へ割り当てられるとは限りません。話者の識別が重要な場合は、手動でラベルを付ける工程を設けるか、最終的な文字起こしの前に適切な話者分離を行えるワークフローを利用してください。
はい。特にテキストを公開したり、重要な意思決定に使用したりする場合は、自動生成された内容を下書きとして扱ってください。名前、数字、句読点、不明瞭な箇所、引用は、元の音声と照合して確認しましょう。